
前言
在第一篇实现 Transformer 时,我们直接使用了原始论文的正弦位置编码,当时只是把它当作一个黑盒;在上一篇讨论归一化时,我们也提到 QK-Norm 与 RoPE 之间存在先后顺序问题。本文就来把这些伏笔收回来:从注意力为什么需要位置信息讲起,沿着绝对位置编码、相对位置编码、ALiBi、RoPE 一路梳理到长度外推,看看现代 LLM 的位置编码是如何一步步演进成今天的样子的。
为什么需要位置编码
排列等变性
回顾 Self-Attention 的计算:
如果不考虑 mask,这个计算对输入序列的顺序是完全无感的:如果把输入 token 的顺序打乱,输出的每一行只会跟着重排,内容本身一个字都不会变。也就是说,「我打他」和「他打我」在 Attention 看来是完全一样的输入——这对语言模型显然是不可接受的。可以用一个玩具实验直接验证:
mha = MHA(d_model, num_heads) # MHA 为 EP.0 中实现的类x = torch.randn(1, L, d_model) # [1, L, d_model]out = mha(x, x, x) # [1, L, d_model]x_flipped = x.flip(1) # [1, L, d_model]out_shuffled = mha(x_flipped, x_flipped, x_flipped)assert torch.allclose(out_shuffled, out.flip(1), atol=1e-5) # 只是跟着重排本文代码注释里统一用 [B, L, ...] 记张量形状:B 是 batch 大小,L 是序列长度,T 是评测代码里的文本总长,H 是注意力头数,d_model 与 d_head 是模型维度和注意力头维度,V 是词表大小。
这个性质称为排列等变(permutation equivariance)。因此,位置信息必须从外部注入。
评价维度
注入位置信息的方式有很多,梳理演进历史之前,先明确评价一种位置编码的几个维度:
- 绝对还是相对:编码的是「token 在第几个位置」,还是「两个 token 相距多远」;
- 能否外推:训练时只见过长度 ,推理时遇到 是否还能正常工作;
- 工程兼容性:是否与 KV cache、FlashAttention 等推理优化兼容;
- 是否引入额外参数与计算。
后面每讲到一种方法,都可以回到这张评分表上对照。而纵观所有方案,注入位置的路其实只有两条:
要么加在 token 表示上,要么藏在 attention logits 里。本文的演进主线,就是位置信息沿着这两条路不断迁移的过程。
绝对位置编码
正弦编码
原始 Transformer 的做法是为每个位置生成一个与 token embedding 同维度的向量,两者相加后送入网络。这个向量不是学出来的,而是按固定公式生成的:
其中 是位置, 是维度下标, 是 embedding 维度。
直觉上,可以把不同维度理解成频率不同的时钟:下标 小的维度周期短、转得快,对应高频;下标大的维度周期长、转得慢,对应低频。每个位置在所有维度上的取值合起来,就构成了一个独一无二的「指纹」——各维周期按几何级数从 一直铺到约 ,类似二进制计数器里不同位以不同速率翻转,任意两个位置总会在某个维度上错开。
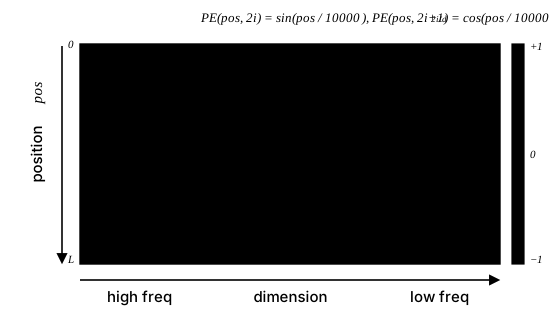
正弦编码还有一个精心设计的性质: 可以表示为 的线性函数。记 ,利用三角函数的和角公式:
即相对偏移 对应一个只依赖 的线性变换。这为模型提供了感知相对位置的线索——不过这个性质当时并没有被充分利用,真正把它发扬光大的是后面的 RoPE。
局限也很明显:外推性差。位置超出训练见过的最大长度后,正弦指纹落到了模型从未见过的区域,行为变得不可预测。正弦编码的实现我们在 EP.0 已经写过,这里不再重复。
可学习编码
BERT、GPT-2 等模型走了另一条更直接的路:准备一张 的嵌入表,让每个位置的编码向量成为可学习参数,随模型一起训练。
self.pos_emb = nn.Embedding(max_len, d_model)x = tok_emb(x) + self.pos_emb(torch.arange(L)) # [B,L,d_model] + [L,d_model]可学习编码更灵活,模型可以自由决定每个位置该长什么样。但代价是 成了硬天花板:训练时表只有 行,推理时遇到更长的序列,要么重训一张更大的表,要么对已有位置做插值——而且插值效果如何并没有保证。
相对位置编码
仔细观察上面的方法会发现一个共同点:它们编码的都是「token 在第几个位置」这样的绝对信息。但注意力真正需要的其实是「 和 相距多远」这样的相对信息。于是一个自然的想法是:
能不能只编码相对距离,而不关心 token 的绝对位置?
相对位置编码的思路就是把位置信息从 token 表示上挪开,注入到 attention logits 里去——也就是 softmax 归一化之前的那个打分矩阵。
相对位置偏置
最早的做法来自 Shaw et al. 2018:为每个相对距离准备一组可学习向量,加到 key 和 value 上,距离超出范围就截断到边缘的桶。用公式写,key 侧变成 ,logits 随之变为:
rel_k = nn.Embedding(2 * max_dist + 1, d_head)
i = torch.arange(L)[:, None] # [L, 1]j = torch.arange(L)[None, :] # [1, L]rel = (j - i).clamp(-max_dist, max_dist) + max_dist # [L, L]
# q, k: [H, L, d_head]logits = (q[:, :, None] * (k[:, None] + rel_k(rel))).sum(-1) / math.sqrt(d_head)T5 把这个思路进一步简化到极致:不再给 key/value 加向量,而是每个注意力头在每个相对距离桶上各学一个标量 bias,直接加到 attention logits 上:
# T5:距离标量直接加在 logits 上;rel 沿用上面的分桶结果rel_b = nn.Embedding(2 * max_dist + 1, H) # 每个头各一套标量
logits = q @ k.transpose(-1, -2) / math.sqrt(d_head) + rel_b(rel).permute(2, 0, 1) # [H, L, L]顺带一提,T5 实际的分桶还会把较大距离按对数压缩进少数几个桶,且这组 bias 只在第一层计算、跨层共享;T5 的实现里也没有显式除以 ,缩放被折进了参数初始化。上面的简单截断和缩放只是示意。
重参数化
Transformer-XL 则走了更理论化的一条路。原始 Transformer 把绝对位置编码 直接加在 token 上,attention logits 按乘法展开后是四项:
每一项都混着绝对位置 、。Transformer-XL 对展开式做重参数化,使每一项都只依赖相对距离:
四项与展开前一一对应:key 侧的绝对位置编码 换成了只依赖 的正弦编码 ,作用于第二、四项;query 侧的 对所有位置是同一个常向量,干脆变成两个可学习参数 、,对应第三、四项,论文称之为 global content bias 与 global position bias。同时 key 的投影矩阵被拆成内容侧 与位置侧 两个,分别服务内容项和位置项。这样位置信息同样只进入 logits,并且还顺带支撑了 Transformer-XL 的 segment 级循环机制。
局限
相对位置编码方向正确,但实现上都有一个共同代价:logits 里多出一个依赖位置对 的项。这个 的偏置矩阵需要额外显存与计算,更关键的是它与 FlashAttention 这类不显式物化 logits 矩阵的实现不兼容——模型可以选择为它退回普通 attention,但推理效率就丢了。这是它们没有成为主流的直接原因。
ALiBi
相对位置偏置仍然需要在 logits 里学一组参数。顺着这个思路可以再推一步:
能不能连位置参数都不学,直接写一个固定的偏置?
ALiBi 的做法简单到有点极端:token 上什么都不加,只在 attention logits 上加一个与距离成正比的固定惩罚项:
其中 是每个注意力头各自的斜率, 个头时按几何级数取 ,例如 8 个头时取 。顺带说明,论文对因果场景写的其实是 ;带上绝对值是让双向情形也成立的写法,在 causal mask 下两者等价:
i = torch.arange(L)[:, None] # [L, 1]j = torch.arange(L)[None, :] # [1, L]slopes = torch.pow(2.0, -torch.arange(1, H + 1) * (8.0 / H)) # [H]bias = -slopes[:, None, None] * (j - i).abs() # [H, L, L]logits = q @ k.transpose(-1, -2) / math.sqrt(d_head) + bias # [H, L, L]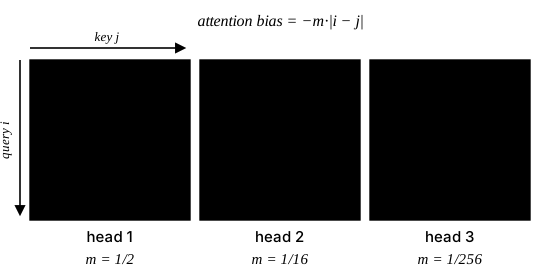
ALiBi 的收益很诱人:零参数、几乎没有额外计算,而且「近处多注意、远处少注意」的归纳偏置天然符合语言的局部性,外推到更长序列时表现意外地好——原论文的标题就叫 Train Short, Test Long。但硬币的另一面是,硬性距离惩罚对需要远程依赖的任务不利;当上下文窗口越来越长、长距离检索越来越重要时,这条路线就逐渐让位给了 RoPE。
RoPE
核心思想
前面几种相对位置编码都是往 logits 里加东西。RoPE 换了一个方向:能不能找到一种变换,让内积 天然只依赖相对距离 ?它给出的答案出人意料地简洁——把 Q、K 各自按自己的绝对位置做旋转:
「旋转」听起来陌生,其实它只是一类保模长的线性变换。这一节我们先把二维情形看清楚——什么是旋转矩阵、它凭什么让内积只依赖相对距离——然后再把它推广到高维。
旋转矩阵
二维平面上,把向量绕原点逆时针旋转 角是一个线性变换。要知道它的矩阵长什么样,看它对两个基向量的作用就够了: 旋转后落在 , 旋转后落在 ——矩阵的列就是基向量的像,于是:
它确实在做旋转而不只是「长得像」:把任意向量写成极坐标 ,左乘 后用三角函数的和角公式:
模长不变,角度恰好加了 。
旋转矩阵有两条性质,它们是后面全部推导的支点:
- 复合:——连续转两次,等于一次转过角度之和;
- 转置即逆:。一行就能验证: 是奇函数、 是偶函数, 转置后恰好等价于把 换成 。
相对位置从哪来
回到注意力。给位置 的 施加旋转 ,给位置 的 施加旋转 —— 是这个二维分量的角频率;记号上注意,这里的 、 是位置下标,与上一节 ALiBi 的斜率 无关。再算内积:
第一步用了转置性质,第二步用了复合性质——绝对位置 、 各自消掉,内积只依赖差值 。token 带着自己的绝对位置旋转,attention logits 却天然只感知相对距离,这就是「给的是绝对位置、产生的是相对效果」。
换个等价的读法:,相当于先把 反向旋转 再与 做内积——只看相对距离,从哪个位置起算都无所谓。另外,把二维分量看作复数还有个更简洁的读法:旋转 就是乘上 ,共轭相乘后相位差自然就是 。
高维扩展
二维向量只有一个旋转平面; 维向量则把维度两两分组,每组在各自的二维子空间里独立旋转。第 组的角频率取几何级数 ,和正弦编码同一套设计:下标小的组转得快、周期短,像时钟的秒针;下标大的组转得慢、周期长,像时针——快针负责区分邻近位置,慢针保证长窗口内相位不重复。 个二维块拼起来, 就是一个块对角矩阵:
每个块都是同一个 ,上面的两条性质逐块成立:、,于是高维下依然有 ,内积依然只依赖相对距离。
这里画出的是原始论文的相邻维配对形式,与下文代码使用的配对方式只差一个维度置换。工程上并不需要真的构造这个稀疏矩阵——展开后会发现它就是「一半乘 cos、一半乘 sin 再互换相加」的逐元素运算,可以直接写成几行代码,也很容易融合进 kernel。
性质
RoPE 有两个值得注意的性质。其一是远程衰减:RoPE 论文在 §3.4.3 给出了注意力得分随距离增大的衰减上界——和 ALiBi 的直觉殊途同归,但机制完全不同。需要注意的是这个结论并不严格单调,各频率分量的叠加会产生波动,所以更准确的说法是「整体上呈现衰减趋势」。
其二是工程兼容性:RoPE 只在 Q、K 上作用,logits 算完它就消失了——attention 内部、FFN、残差流里都没有它的痕迹。因此它与 KV cache、FlashAttention 完全兼容,这正是它在工程上完胜前面那些方案的原因。
实现细节
读开源代码时有两个细节必须先确认,否则很容易踩坑:
- 维度配对方式。RoPE 原始论文和 Meta 官方 LLaMA 实现都是相邻维两两配对 ,即 interleaved;而 HuggingFace transformers 的实现是前后两半配对 ,即 GPT-NeoX 风格的 half-split,HF 在权重转换时做了维度置换补偿。两者只差一个维度置换,数学上等价,但混用会得到完全不同的结果;
- base 的选择。原始值取 10000,它决定低频维的波长。base 越大,低频维转得越慢、能覆盖的上下文越长——它是后面所有长度外推技巧的总旋钮;
- QK-Norm 与 RoPE 的先后。上一篇留下的问题在这里收尾:RoPE 是保模长的旋转,不改变向量的 RMS,因此不带可学习参数时,先 Norm 后 RoPE 与先 RoPE 后 Norm 完全等价。真正的差别在逐维缩放 上——先归一化再旋转, 作用在与位置无关的固定坐标上;反过来, 就作用在随位置旋转的坐标系里,等价于让每个位置学一套不同的缩放。主流实现都把 QK-Norm 放在 RoPE 之前,让归一化只管内容、位置全部交给旋转。
解耦 RoPE
RoPE 与 KV cache 兼容,但它让 K 依赖绝对位置这一点,在某些架构里反而会出问题。DeepSeek-V2 的 MLA 就是一个例子:MLA 想把 KV 压成一个低秩的隐向量存进 cache,但如果 K 带了 RoPE,位置信息与内容纠缠在一起,压缩表示就不再成立。
DeepSeek 的解法是解耦 RoPE:把 key 拆成两条通路——一条走低秩压缩、不带 RoPE,承载语义内容;另一条是一个各头共享的窄 key,在 DeepSeek-V2 中仅 64 维,不做压缩、专门携带 RoPE 位置信息。用一小部分额外容量,换来了「KV 可压缩」和「位置可编码」两者兼得。这也是 RoPE 进入现代 LLM 架构设计的一个代表性案例,和 EP.1 的 DeepSeekMoE 一脉相承——至于 MLA 完整的计算路径长什么样,我们留到后面讲 MLA 的文章里展开。
代码实现
先用矩阵形式把推导坐实。RoPE 的旋转矩阵是块对角的,每个 块对应一对维度、一个频率。下面采用 half-split 配对,即第 维与第 维一组:
def rope_matrix(pos: int, d_head: int, base: float = 10000.0) -> torch.Tensor: inv_freq = base ** (-torch.arange(0, d_head, 2).float() / d_head) # [d_head/2] R = torch.zeros(d_head, d_head) # [d_head, d_head] half = d_head // 2 for i, theta in enumerate(pos * inv_freq): # 第 i 维与第 i+d_head/2 维配对 c, s = theta.cos(), theta.sin() R[i, i] = c; R[i, i + half] = -s R[i + half, i] = s; R[i + half, i + half] = c return R # [d_head, d_head],R(pos)工程实现不建矩阵:预计算每个位置的 cos/sin,对向量做逐元素运算即可。
def precompute_cos_sin(L: int, d_head: int, base: float = 10000.0): inv_freq = base ** (-torch.arange(0, d_head, 2).float() / d_head) # [d_head/2] pos = torch.arange(L).float() # [L] angles = pos[:, None] * inv_freq[None, :] # [L, d_head/2] return angles.cos(), angles.sin()
def apply_rope(x: torch.Tensor, cos: torch.Tensor, sin: torch.Tensor) -> torch.Tensor: """ x: [..., d_head] cos/sin: [..., d_head/2] """ x1, x2 = x.chunk(2, dim=-1) # [..., d_head/2], [..., d_head/2] return torch.cat([x1 * cos - x2 * sin, x2 * cos + x1 * sin], dim=-1) # [..., d_head]apply_rope 里 x1 * cos - x2 * sin 与 x2 * cos + x1 * sin 正是 旋转矩阵 的展开,配对约定与上面的 rope_matrix 保持一致。把它套回注意力里 [B, L, H, D] 形状的 Q/K 时,记得把 cos/sin 补成 [1, L, 1, d/2] 的广播形状。
最后数值验证 RoPE 的核心性质:内积只依赖相对位置。
cos, sin = precompute_cos_sin(L=512, d_head=64) # [L, d_head/2], [L, d_head/2]q, k = torch.randn(64), torch.randn(64) # [d_head], [d_head]m, n = 100, 37
lhs = apply_rope(q, cos[m], sin[m]) @ apply_rope(k, cos[n], sin[n])rhs = (rope_matrix(m - n, 64) @ q) @ k # (R_{m-n} q) · kassert torch.allclose(lhs, rhs, atol=1e-5)长度外推
RoPE 性质很好,但它有一个软肋:外推。训练时模型只见过长度 以内的位置。高频维的 接近 1,在训练长度内已经转过很多个整周期,所有相位都见过;低频维的 接近 ,在 里可能连一圈都没转完——推理时位置一旦超出 ,首先落进训练时从未出现过的相位区间的就是低频维,模型的困惑度(ppl)随之急剧上升:
围绕这个问题,社区发展出了一系列补救手段。
位置插值
Position Interpolation 的思路很直接:既然位置 没见过,那就把所有位置除以缩放因子 ,把 的位置压回 的训练区间:
代价是相邻位置的区分度被压缩了 倍,高频维的分辨率受影响最明显,因此 PI 通常需要配合少量步数的微调才能让模型重新适应。
缩放 base
PI 对所有维度等比缩放,但高频维在 内就已经转过很多圈,插值对它们的伤害最大。NTK-aware 缩放的思路是不动位置、改 base:目标长度是训练长度的 倍时,把 base 按 调大,让低频维转得更慢,从而把视角拉远。高频维几乎不受影响,低频维被拉伸——不微调也能获得一定的外推能力。推理时按输入长度动态调整 base 的 Dynamic NTK,就是 Qwen 等模型的实际用法。
另一条更粗暴的路是直接在训练期换尺子:LLaMA 2 → 3 把 RoPE base 从 10000 提到 500000,让模型在更长的上下文上从头训练。可以看到,NTK 缩放和调大 base 拧的是同一个旋钮 ,只是一个改在推理侧、一个改在训练侧。
YaRN
YaRN 是目前开源模型拉长上下文的主流方案。它按频率分段处理:高频维直接外推,低频维做插值,中间频段按线性斜坡平滑过渡(NTK-by-parts);再对 attention logits 乘温度系数 做校正,弥补插值后注意力分布变软的问题。相比 PI 它所需的微调量要少一个数量级,配合动态缩放的 Dynamic-YaRN 甚至可以完全免微调;相比纯 NTK 缩放它的外推质量更好。
评估方式
需要注意的是,外推效果好坏不能只看 ppl:一个只关注局部的模型也能拿到不错的 ppl。真正的检验是 needle-in-a-haystack 这类长距离检索任务——在长上下文的任意位置藏一条信息,看模型能不能找回来。
代码实现
PI 和缩放 base 都只需要动 precompute_cos_sin 里的一行:
# Position Interpolation:位置除以缩放因子 sangles = (pos[:, None] / s) * inv_freq[None, :] # [L, d_head/2]
# 缩放 base:换 inv_freq,高频维几乎不变、低频维被拉伸inv_freq = new_base ** (-torch.arange(0, d_head, 2).float() / d_head) # [d_head/2],θ_i = new_base^{-2i/d_head}评估外推效果可以用滑窗 ppl:固定窗口向前滑动,累计每个 token 的负对数似然,画出不同上下文长度下的 ppl 曲线。
def eval_ppl(model, ids: torch.Tensor, ctx_len: int, stride: int = 256) -> float: # ids: [B, T],token id nll_sum, n_tok = 0.0, 0 prev_end = 0 for begin in range(0, ids.size(1) - 1, stride): end = min(begin + ctx_len, ids.size(1)) logits = model(ids[:, begin:end]).logits # [B, ctx, V],ctx 为当前窗口长度 # 只评相对上个窗口新增的 token,首窗口从第 1 个起,保证不重不漏 trg = min(end - prev_end, end - begin - 1) # logits[i] 预测的是第 begin+i+1 个 token,尾部 trg 个目标对应下标 [-trg-1:-1] nll_sum += F.cross_entropy(logits[0, -trg - 1 : -1], ids[0, end - trg : end], reduction="sum").item() n_tok += trg prev_end = end if end == ids.size(1): break return math.exp(nll_sum / n_tok)
只改 base 不微调时,曲线会在超过训练长度后明显抬升;PI 和 NTK 类方法则能把它压平。用这样一条曲线来评估外推方案,比单看一个数字要直观得多。
NoPE
讨论到这里,一个更根本的问题值得反问一下:
我们真的需要位置编码吗?
Haviv et al. 2022 的答案是「未必」。Decoder-only 模型的因果 mask 本身就泄露了位置信息:第 个 token 只能看到前 个位置,可见序列的长度就隐含了它的绝对位置。这一点两行代码就能看清:
visible = torch.tril(torch.ones(L, L)).sum(dim=-1) # [L] = 1, 2, ..., L# 第 t 个 token 可见的 key 数恰好是它的位置序号,位置信息免费藏在 mask 里实验证明不加任何位置编码的 Decoder-only 模型也能正常工作;Kazemnejad et al. 2023 更系统地比较后还发现,NoPE 在下游长度泛化任务上甚至优于各类显式位置编码。
不过 NoPE 并没有成为主流——显式的位置编码仍然带来了更好的收敛速度与下游效果。但这个方向提醒我们:位置信息未必只能从「加法」或「旋转」里来,模型结构本身也可以是一种编码。
多维位置编码
最后提一句多维扩展。在图像和视频里,位置是二维甚至三维的,处理思路和 RoPE 一脉相承:把 切成几段,每一段负责一个坐标轴,各自做一维旋转。RoPE-ViT 这类工作就是这样做的,Qwen2-VL 的 M-RoPE 把时间、高度、宽度三个维度分开编码,也是同一个思路,这里点到为止。
结语
回顾位置编码的演进,主线其实很清晰:正弦编码和可学习编码把位置加在 token 上,相对位置偏置和 ALiBi 把它藏进 logits 里,RoPE 则把这个「相对偏移」做成了旋转——既保留了相对位置的语义,又不给 attention 计算和推理引擎添任何负担,这是它能成为现代 LLM 默认选择的根本原因。
至于长度外推,PI、NTK、YaRN 三代方法拧的都是同一个旋钮:让低频维的旋转角始终落在模型见过的范围内。理解了 RoPE 的频率结构,这些技巧就只是同一个思想的不同实现。
下一篇我们暂时离开模型结构,聊聊训练侧的话题:PPO。
参考资料
- Attention Is All You Need
- Self-Attention with Relative Position Representations
- Transformer-XL: Attentive Language Models Beyond a Fixed-Length Context
- Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer
- Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation
- RoFormer: Enhanced Transformer with Rotary Position Embedding
- Extending Context Window of Large Language Models via Positional Interpolation
- YaRN: Efficient Context Window Extension of Large Language Models
- DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model
- Transformer Language Models without Positional Encodings Still Learn Positional Information
- The Impact of Positional Encoding on Length Generalization in Transformers