
前言
在上一篇文章中,我们学习了基础的 Transformer,了解了 MHA、FFN 等核心原理,这为我们后续的学习奠定了基础。 现代 LLM 几乎都是基于 Transformer 进行各种改造和创新而实现的,因此接下来我们将逐步讨论这些用于提升模型性能与效率的技术。 本文要讨论的就是其中一项关键技术:Mixture-of-Experts(MoE),包括其问题背景、核心原理以及实际应用。
为什么需要 MoE
在早期的大语言模型中,Transformer 的 FFN 通常采用 Dense 结构,即每次输入都会经过完整的 FFN。 随着 Scaling Law 的发展,人们发现扩大模型规模通常能够提升模型的能力,因此 LLM 的参数量不断增长。 然而,在一定的计算预算下,模型参数量、训练数据量和训练计算量之间存在复杂的 trade-off:更大的模型通常具有更高的参数容量,但同时也需要更多计算资源进行训练和推理。 因此,一个自然的问题是:
能否让模型拥有更多的参数,从而获得更大的参数容量,同时减少模型的计算量?
MoE 正是解决这一问题的重要方法之一。其早期代表性工作可参考稀疏门控 MoE。 MoE 将模型中的部分 Dense 层替换为由多个 Expert 组成的稀疏结构,并通过 Router 根据输入 token 动态选择少量 Expert。这样,模型的总参数量可以显著增加,而实际参与计算的激活参数量仍然可以保持在较低水平。 因此,MoE 的核心思想可以概括为:
这种稀疏激活机制使模型能够在参数容量与计算成本之间取得更灵活的平衡。Switch Transformer、GShard 等工作也展示了稀疏 MoE 在大规模语言模型中的应用潜力。
MoE 是什么
在现代 Transformer-based LLM 中,MoE 最常见的应用方式是将 Transformer Block 中的 FFN 替换为 MoE Layer,例如 Switch Transformer 和 GShard。
基础的 FFN 通常由两个线性层组成,中间使用一个非线性激活函数,其隐藏层维度通常会大于输入维度。因此,随着模型规模扩大,FFN 往往会占据模型中相当大的一部分参数。在 Dense Transformer 中,每个 token 都会经过完整的 FFN。也就是说,无论当前 token 的内容是什么,都需要使用同一组 FFN 参数。
MoE 则将一个 Dense FFN 替换为多个相互独立的 Expert,并在前向传播时只选择其中一部分 Expert 处理当前 token。例如,一个 MoE Layer 可以包含 个 Expert,但每个 token 只激活其中 个 Expert,其中 。因此,模型可以拥有大量 Expert,从而增加总参数量,但每个 token 实际参与计算的 Expert 数量仍然较少。
参数量分析
首先需要特别区分两个概念:
- Total Parameters:模型中所有参数的总量;
- Active Parameters:处理一个 token 时实际参与计算的参数量。
MoE 的优势正是来自二者之间的差异:
需要注意的是,MoE 并不意味着整个模型的计算量简单地变成原来的 。Attention、Router 以及 Expert 之间的通信等部分仍然需要额外计算。因此,更准确地说,MoE 主要降低的是其中稀疏 Expert 部分的计算量。要理解这一改动对计算量的影响,首先需要明确每个 Expert 的规模是如何确定的。
设原 Dense FFN 的输入与输出维度均为 ,隐藏维度为 ,即:
原始 Transformer 通常取 。其计算量,若以 MACs 粗略衡量,约为:
将其替换为 个 Expert 时,有两种常见方案。
等参拆分
如果希望 个 Expert 的参数量总和与原来的 Dense FFN 相当,那么每个 Expert 的隐藏维度需要相应缩小:
即每个 Expert 为:
每个 Expert 的计算量约为 , 个 Expert 的总计算量为:
与原来的 Dense FFN 完全一致。
如果每个 token 只激活其中 个 Expert,则实际 Expert 计算量为:
即:
这正是“Expert 部分计算量约为原 Dense FFN 的 ”这一结论的来源,也是 Switch Transformer 等工作中稀疏 MoE 的典型设定。
扩容拆分
另一种常见做法是让每个 Expert 保持与原来 Dense FFN 相当的规模,甚至更大。此时总参数量约为原来的 倍。若每个 Expert 仍为:
则每个 Expert 的计算量等于原 Dense FFN,每个 token 激活 个 Expert 时,实际计算量为原 Dense FFN 的 倍。此时 仅表示激活了总 Expert 容量的 ,并不代表计算量降为原 Dense FFN 的 。这一区别在理解 MoE 的实际计算成本时尤为重要。
数值示例
以 GPT-2 small 为例,其 ,,因此原 Dense FFN 的计算量为 。
若采用等参拆分,将其拆分为 个 Expert,则每个 Expert 的隐藏维度为 ,即每个 Expert 为 ,计算量为 。 个 Expert 的总计算量为 ,与原 Dense FFN 一致。
每个 token 激活其中 个 Expert 时,实际计算量为 ,占比为:
若采用扩容拆分,每个 Expert 仍为 ,计算量为 。每个 token 激活 个 Expert 时,实际计算量为 ,为原 Dense FFN 的 倍,而非 。
路由
为了减少每次前向传播的计算量,MoE 将原本的一个 FFN 替换为 个独立的 Expert,每次只激活其中 个。这一思路可追溯到稀疏门控 MoE。
例如,一个 MoE Layer 包含 8 个 Expert,每个 token 只激活其中 2 个。如果采用上一节所说的等参拆分,即 8 个 Expert 合起来才对应原来一个 Dense FFN,那么在忽略 Router、通信等额外开销,并假设每个 Expert 计算量相同的情况下,Expert 部分的计算量约为原 Dense FFN 的:
但要注意,这个结论依赖于等参拆分。如果采用扩容拆分,则激活 2 个 Expert 的计算量是原 Dense FFN 的 2 倍;此时 只表示激活了总 Expert 容量的 。因此,MoE 的稀疏激活来自:对一个 token 只计算被选中的 个 Expert,而不是计算全部 个 Expert。单个 Expert 是否比原 Dense FFN 小,取决于拆分方案:
- 如果采用等参拆分,每个 Expert 确实会变小,但 个 Expert 合起来与原 Dense FFN 相当;
- 如果采用扩容拆分,每个 Expert 可以保持原规模,此时激活计算量可能大于原 Dense FFN,但相对于所有 Expert 的总容量仍然只激活了 。
但是,对于一个输入 token,我们需要知道应该选择哪些 Expert,这就需要 Router。关于 Router 与稀疏门控的经典设计,可参考稀疏门控 MoE。
最简单的一种 Router 可以使用一个可学习的线性层,将输入 token 的隐藏状态 映射到 个 Expert 对应的 routing score:
其中 是输入 token 的隐藏状态, 是 Router 的可学习参数, 是每个 Expert 对应的 routing score。接下来,Router 先对所有 个 Expert 的 score 做 Softmax,得到每个 Expert 的 routing probability,这也是 Switch Transformer 中的定义:
记 为所有 Expert 的 routing probability 组成的向量,然后选出概率最高的 个 Expert,记为集合 ,并只对被选中的 Expert 将概率归一化,得到 routing weight:
这样保证 。最终,只有这些被选中的 Expert 会参与当前 token 的计算,并根据对应的 routing weight 对 Expert 的输出进行加权求和:
其中 表示第 个 Expert。
以上过程可以独立实现为一个 Router 模块:
class Router(nn.Module): def __init__(self, d_model: int, num_experts: int, top_k: int) -> None: super().__init__() self.top_k = top_k self.weight = nn.Linear(d_model, num_experts, bias=False)
def forward(self, x: torch.Tensor) -> tuple[torch.Tensor, torch.Tensor, torch.Tensor]: logits = self.weight(x) # [T, N] probs = torch.softmax(logits, dim=-1) # [T, N] topk_probs, topk_idx = probs.topk(self.top_k, dim=-1) routing_weights = topk_probs / topk_probs.sum(dim=-1, keepdim=True) # [T, K] return probs, topk_idx, routing_weights其中 probs 保留所有 Expert 的 routing probability,topk_idx 与 routing_weights 是 Top-K 选择与归一化的结果,三者都会在后续 MoE Layer 的 dispatch 与负载均衡损失中使用。
到这里,MoE 已经实现了稀疏计算,但又出现了一个新的问题:
Router 会不会把大量 token 都发送给少数几个 Expert?
如果某些 Expert 被频繁选择,而其他 Expert 几乎没有 token,那么虽然模型拥有大量参数,但实际上只有少数 Expert 得到了充分训练和使用。因此,我们还需要解决 Expert 之间的负载均衡问题。
负载均衡
理想情况下,如果有 个 Expert,那么一个 batch 的 tokens 应该比较均匀地分配到这些 Expert。例如 ,,如果完全均衡,那么每个 Expert 平均处理的 token 数量为:
但实际上,Router 会根据 token 的内容动态进行选择,因此不同 Expert 接收到的 token 数量可能存在较大差异。如果大量 token 都被发送给同一个 Expert,就会产生两个问题:
- 部分 Expert 负载过高,成为整个 MoE Layer 的计算瓶颈;
- 其他 Expert 接收到的 token 太少,导致这些参数无法得到充分训练。
因此,MoE 通常会引入额外的 Load Balancing Loss,鼓励 Router 将 token 更均衡地分配给不同 Expert。一种经典的方法来自 Switch Transformer。 对于一个 batch,可以定义 Expert 实际接收到的 token 比例为:
其中 是 batch 中的 token 数量, 为指示函数,当其中的条件成立时取值为 ,否则取值为 。同时,可以计算 Router 对 Expert 的平均概率:
其中 就是上一节定义的 routing probability,即 token 经 Softmax 后对 Expert 的概率。然后可以构造一个辅助损失:
其中 用于控制负载均衡损失对整体训练目标的影响。
为什么乘积 能鼓励均衡分配?关键在于两者的可微性不同: 来自 Top-K 的硬选择,对 Router 参数不可微分; 是 Softmax 的软概率,可微分。因此梯度只通过 传播,而 只作为系数携带负载信息。对 求偏导:
也就是说,某个 Expert 接收的 token 越多, 就越大,Router 分配给它的概率就会被越强地压低。这是一个负反馈:过载的 Expert 在后续迭代中被分配的概率降低,接收的 token 随之减少,直到各 Expert 的负载趋于均衡。反过来,负载越低的 Expert 受到的抑制越弱,Router 自然会把更多概率分配给它们。
另外,系数中的 是归一化因子:完全均衡时每个 Expert 被分配的比例为 ,代入可得 ,损失值与 Expert 数量无关,因此 可以在不同规模的 MoE 中统一控制辅助损失的权重。
这个损失的目的并不是要求所有 Expert 学习完全相同的内容,而是避免 Router 长期将大量 token 集中发送到少数 Expert,从而改善 Expert 的利用率。
对应的辅助损失可以写为:
def load_balancing_loss( probs: torch.Tensor, # [T, N] topk_idx: torch.Tensor, # [T, K] alpha: float,) -> torch.Tensor: N = probs.size(1) dispatch_mask = torch.zeros_like(probs) dispatch_mask.scatter_(1, topk_idx, 1.0) # [T, N] f = dispatch_mask.mean(dim=0) # [N] P = probs.mean(dim=0) # [N] return alpha * N * (f * P).sum()其中 dispatch_mask 对应公式中的指示函数 ,由离散的 topk_idx 计数得到,天然不可微分;梯度只经由 P 传回 Router 参数,与前文的分析一致。
不过,即使加入了负载均衡损失,实际路由过程中仍然可能出现某个 Expert 接收到过多 token 的情况。因此,MoE 通常还需要为每个 Expert 设置一个容量上限,即 Expert Capacity。Switch Transformer 和 GShard 都讨论了 Expert Capacity、token dispatch 与 overflow 等问题。
一个常见的计算方式为:
其中 是每个 Expert 的容量, 是 batch 中的 token 数量, 是 Expert 数量, 是 Capacity Factor。Capacity Factor 为 Expert 额外提供了一定的缓冲空间。例如,当 时,每个 Expert 的容量大约等于平均分配情况下的 token 数量;当 时,容量在平均分配量的基础上留出余量,Expert 可以接收超过平均数量的 token,从而减少因容量不足而被丢弃的 token。
对应的容量计算:
def expert_capacity(T: int, num_experts: int, capacity_factor: float) -> int: return math.ceil(T / num_experts * capacity_factor)这种被丢弃的情况称为 token overflow:如果某个 Expert 接收到的 token 数量超过了它的容量,超出部分的 token 将无法被该 Expert 处理。不同 MoE 实现对于 overflow token 的处理方式有所不同,因此 Expert Capacity 也是实际 MoE 实现中的重要问题。
到这里,一个基础的 MoE Layer 就包含了几个核心组件:
但此时又会出现一个新的问题:
如果我们希望不同 Expert 学习不同的知识,那么如何让 Expert 真正形成专业化分工?
如果仅仅增加 Expert 数量并进行 Top-K Routing,不同 Expert 之间仍然可能学习到大量重复的知识。这也是后续 DeepSeekMoE 希望解决的问题。
代码实现
在代码实现中,可以先实现一个最基础的 Top-K MoE Layer。
整体流程可以抽象为:
对于输入 ,Router 首先计算 ,得到 。然后对每个 token 的 score 做 Softmax 得到概率,进行 Top-K 选择并对选中项归一化,得到对应的 Expert index 和 routing weight。之后,将 token 分发到对应的 Expert 中进行 FFN 计算:
其中 为第 个 token 被选中的 Expert 集合, 为对应的 routing weight。最后再将不同 Expert 的结果按照原 token 的顺序重新组合。
基于前文实现的 Router、expert_capacity 与 load_balancing_loss,可以组装出一个完整的 MoE Layer:
class MoELayer(nn.Module): def __init__( self, d_model: int, d_ff: int, num_experts: int, top_k: int, alpha: float = 0.01, capacity_factor: float = 1.0, ) -> None: super().__init__() self.num_experts = num_experts self.top_k = top_k self.alpha = alpha self.capacity_factor = capacity_factor
self.router = Router(d_model, num_experts, top_k)
# 等参拆分(扩容拆分时为 d_ff) expert_hidden = d_ff // num_experts
self.experts = nn.ModuleList([ nn.Sequential( nn.Linear(d_model, expert_hidden), nn.GELU(), nn.Linear(expert_hidden, d_model), ) for _ in range(num_experts) ])
def forward(self, x: torch.Tensor) -> tuple[torch.Tensor, torch.Tensor]: # x: [T, d_model] probs, topk_idx, routing_weights = self.router(x) capacity = expert_capacity(x.size(0), self.num_experts, self.capacity_factor)
y = torch.zeros_like(x) for i in range(self.top_k): expert_ids = topk_idx[:, i] # [T] weights = routing_weights[:, i] # [T] for e in range(self.num_experts): token_ids = (expert_ids == e).nonzero().squeeze(-1)[:capacity] if token_ids.numel() > 0: expert_out = self.experts[e](x[token_ids]) y[token_ids] += weights[token_ids].unsqueeze(-1) * expert_out
aux_loss = load_balancing_loss(probs, topk_idx, self.alpha) return y, aux_loss每个 Expert 在每个 Top-K 位置最多接收 capacity 个 token,超出的 token 会被直接丢弃,即前文所说的 overflow。返回的 aux_loss 即负载均衡辅助损失,训练时可加入总的优化目标。
在实际的大规模 MoE 模型中,还涉及跨设备的 token dispatch 与通信,因此实际实现会比上述过程复杂得多。Switch Transformer 的实现就需要显式处理 token dispatch 和 overflow 等问题。
DeepSeekMoE
基础 MoE 解决了“增加模型参数容量,同时控制每个 token 的计算量”这一问题,但仍然存在一个重要问题:
如何让不同 Expert 学习更加不同、更加专门化的知识?
DeepSeekMoE 正是在这个问题上进一步改进了传统 MoE,其核心思想包括两个部分:
- Fine-Grained Expert:细粒度 Expert
- Shared Expert:共享 Expert
DeepSeekMoE 论文 将这两种设计作为其核心架构,并通过增加更细粒度的 Expert 来提高不同 Expert 之间组合的灵活性,同时通过共享 Expert 捕获不同 token 之间的共同知识。
细粒度与共享专家
传统 MoE 通常将 FFN 划分为 个较大的 Expert,然后每个 token 激活其中 个。DeepSeekMoE 首先进一步将原来的 Expert 划分成更多、更小的 Expert:假设原来的 MoE 有 个 Expert,每个 token 激活 个 Expert,DeepSeekMoE 将每个 Expert 进一步划分,使 Expert 数量增加到原来的 倍,即 ;每个 token 激活的 Expert 数量也相应增加到 ,即 。
这样做并不会简单地增加计算量,因为单个 Expert 的规模也相应减小。在保持激活参数量大致相近的情况下,更多、更小的 Expert 可以提供更加灵活的组合方式。例如,原本一个 token 只能从 中选择 个较大的 Expert;细粒度划分后,它可以从更多的小 Expert 中选择 个。这使得不同 token 可以组合出更加丰富的 Expert 子集,从而减少不同 Expert 之间的知识冗余,并促进 Expert specialization。
但是,如果所有 Expert 都依赖 Router 进行选择,那么某些基础的、所有 token 都需要的知识也可能被重复学习。因此,DeepSeekMoE 又引入了 Shared Expert。Shared Expert 不参与普通的 Top-K Routed Expert 竞争,而是对所有 token 都进行计算,用于学习不同 token 之间更加通用、共享的知识。
于是,整个结构可以理解为:
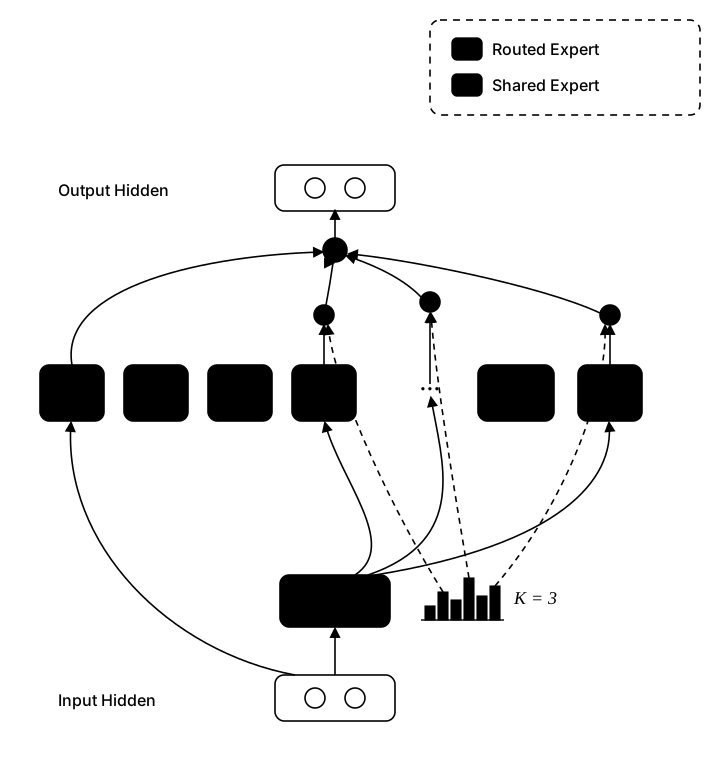
因此,DeepSeekMoE 可以看作是在基础 MoE 的基础上进一步回答了两个问题:
- 如何让 Expert 更加细粒度,从而形成更加灵活的专业化分工?
- 如何将通用知识从 Routed Experts 中分离出来,减少 Expert 之间的重复学习?
这也构成了 DeepSeekMoE 相较于传统 MoE 的核心设计思想。
代码实现
DeepSeekMoE 的代码实现可以在基础 MoE 上继续扩展,核心变化是:
- 将 Routed Expert 的隐藏维度设置得更小,使 Expert 数量更多、粒度更细;
- 增加一个或多个 Shared Expert,并让所有 token 都经过 Shared Expert;
- 将 Routed Expert 的输出与 Shared Expert 的输出相加。
对应的输出可以写为:
其中 为 Shared Expert 集合, 为第 个 token 被 Top-K 选中的 Routed Expert 集合。
在前述 MoELayer 的基础上扩展:
class DeepSeekMoELayer(nn.Module): def __init__( self, d_model: int, d_ff: int, num_routed_experts: int, num_shared_experts: int, top_k: int, alpha: float = 0.01, capacity_factor: float = 1.0, ) -> None: super().__init__() self.num_routed_experts = num_routed_experts self.top_k = top_k self.alpha = alpha self.capacity_factor = capacity_factor
self.router = Router(d_model, num_routed_experts, top_k)
expert_hidden = d_ff // num_routed_experts
def make_expert() -> nn.Module: return nn.Sequential( nn.Linear(d_model, expert_hidden), nn.GELU(), nn.Linear(expert_hidden, d_model), )
self.routed_experts = nn.ModuleList( [make_expert() for _ in range(num_routed_experts)] ) self.shared_experts = nn.ModuleList( [make_expert() for _ in range(num_shared_experts)] )
def forward(self, x: torch.Tensor) -> tuple[torch.Tensor, torch.Tensor]: # x: [T, d_model] probs, topk_idx, routing_weights = self.router(x) capacity = expert_capacity(x.size(0), self.num_routed_experts, self.capacity_factor)
shared_out = torch.zeros_like(x) for expert in self.shared_experts: shared_out += expert(x)
routed_out = torch.zeros_like(x) for i in range(self.top_k): expert_ids = topk_idx[:, i] # [T] weights = routing_weights[:, i] # [T] for e in range(self.num_routed_experts): token_ids = (expert_ids == e).nonzero().squeeze(-1)[:capacity] if token_ids.numel() > 0: expert_out = self.routed_experts[e](x[token_ids]) routed_out[token_ids] += weights[token_ids].unsqueeze(-1) * expert_out
aux_loss = load_balancing_loss(probs, topk_idx, self.alpha) return shared_out + routed_out, aux_loss可以看到,DeepSeekMoE 的 dispatch 流程与基础 MoE 完全一致,差异只在两点:Expert 被切得更小、更多,以及多了一组对所有 token 恒激活的 Shared Expert。实际模型中还会有更精细的配置,例如 DeepSeek-V2 将 gating 改为 sigmoid 打分后对选中项归一化,DeepSeek-V3 又在 Router 中引入 bias 项实现无辅助损失的负载均衡,但核心结构仍然是“细粒度 Routed Expert + Shared Expert”。
结语
MoE 的核心并不是简单地把模型“变小”,而是通过稀疏激活,让模型拥有更大的总参数容量,同时只让其中一部分参数参与当前 token 的计算。
理解 MoE 时,最关键的是区分三件事:
- 总参数量 / 总 Expert 容量是多少;
- 每个 Expert 相对于原 Dense FFN 有多大;
- 每个 token 激活几个 Expert。
只有在这个基础上,公式 才有明确含义。若采用等参拆分,它可以直接表示“Expert 部分计算量约为原 Dense FFN 的 ”;若采用扩容拆分,它只表示“激活了总 Expert 容量的 ”,并不等于原 Dense FFN 的计算量比例。
参考资料
- Scaling Laws for Neural Language Models
- Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer
- Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity
- GShard: Scaling Giant Models with Conditional Computation and Automatic Sharding
- DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models
- 一文搞懂DeepSeek核心技术-DeepSeekMoE
- RethinkFun 深度学习