
前言
前面几篇文章聊的都是模型和系统层面的东西,但无论读论文还是做工程,最后总会落到同一个问题上:这玩意得用什么卡跑。
NVIDIA 的产品线命名并不友好:GeForce、RTX PRO、Tesla、数据中心 GPU 之间横跨了三代命名体系,同一颗芯片换个散热和显存配置就又是另一张卡。接下来三篇文章分别回答三个问题:都有哪些卡、怎么判断一张卡行不行、按需求怎么选。本文是第一篇,先把 NVIDIA 面向 AI 的产品线捋一遍。
范围上限定在 NVIDIA。这不是因为别家不值得讲——AMD 的 MI300X 和国产卡在特定场景下都很有竞争力——而是因为 CUDA 生态目前是事实标准,先把这条主线讲清楚,再谈替代方案才不致于变成参数的堆砌。昇腾等国产卡后续会单独开一篇。
先用一张图预览全文的地图:NVIDIA 面向 AI 的 GPU 大致可以分成五条线,每条线的显存、互联和许可策略完全不同。
下面按这个顺序逐条展开。
GeForce 消费级
消费级是绝大多数人接触 GPU 的起点。对 AI 场景来说,消费级最实用的坐标系不是型号数字,而是显存容量。
显存档位
| 档位 | 代表型号 | 显存 | 显存带宽 |
|---|---|---|---|
| 入门 | RTX 3060 12G | 12 GB | 360 GB/s |
| 甜点 | RTX 4060 Ti 16G / 5060 Ti 16G | 16 GB | 288 / 448 GB/s |
| 中高端 | RTX 4070 Ti S / 5080 | 16 GB | 672 / 960 GB/s |
| 上代遗珠 | RTX 3090 | 24 GB | 936 GB/s |
| 旗舰 | RTX 4090 | 24 GB | 1008 GB/s |
| 当代旗舰 | RTX 5090 | 32 GB | 1792 GB/s |
几个值得注意的点:
- 16 GB 是甜点档:4060 Ti 16G 和 5060 Ti 16G 用中端核心配了大显存,带宽不高但容量够,是本地跑量化模型的最低成本入场券。
- RTX 3060 12G 是个异类:它是 30 系里最便宜的 12G 卡,发布多年后仍活跃在二手和租赁市场,原因无他:同价位买不到更大的显存。
- 3090 尚未过时:发布六年的老旗舰靠着 24G 显存和一项后继无人特性,至今仍是多卡方案的常客,下面讲。
- 32 GB 只有 5090:消费级显存的上限长期停在 24 GB,5090 才把上限抬到 32 GB——这也是它一度被抢到缺货的原因之一。
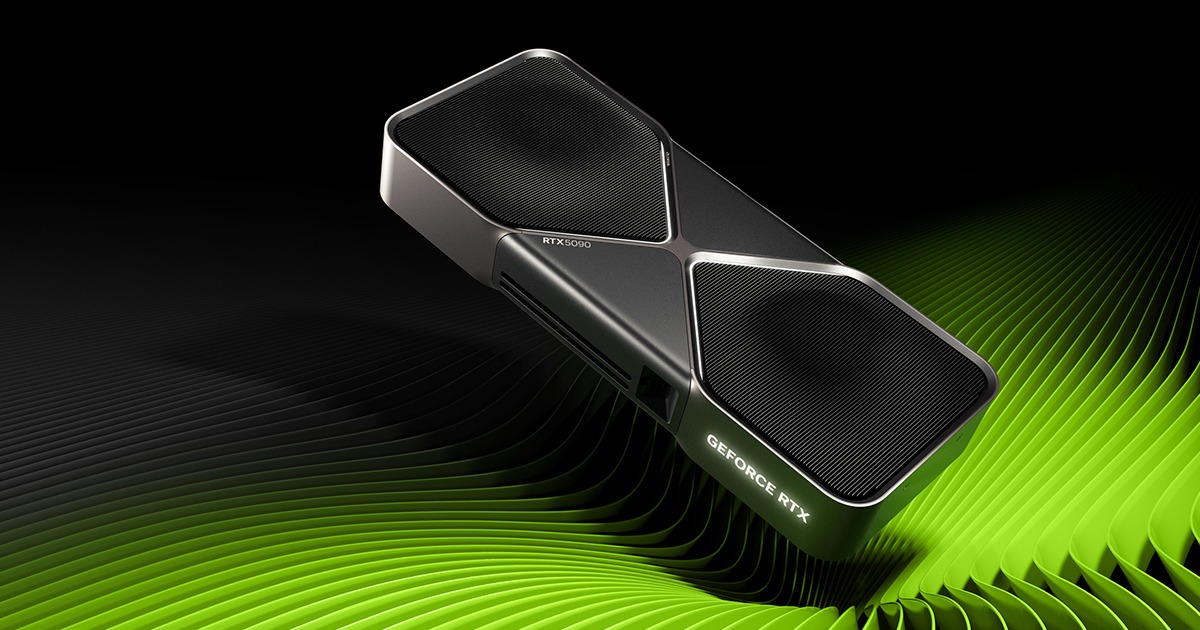
当代旗舰长这样——Founders Edition 的双流式散热设计,也是目前消费级唯一摸到 32G 显存的卡:
代际差异
30、40、50 三系的代差主要体现在两个地方:
Tensor Core 代数:30 系是第三代,40 系第四代并加入 FP8 支持,50 系第五代加入 FP4。每代新精度都让峰值算力上一个台阶,但新精度要等软件栈跟上才兑现——5090 发布初期就吃过 PyTorch 尚未适配新计算架构的亏,实测一度跑不过 4090。
显存技术:中高端卡在 40 系及以前用 GDDR6X,入门款其实是普通 GDDR6,50 系主力换 GDDR7;旗舰还把位宽从 384-bit 扩到 512-bit,带宽从 1008 GB/s 提到 1792 GB/s,涨幅约 78%,远高于同期稠密算力的涨幅——至于新精度口径的算力数字,那是另一套故事,下一篇细讲。后面会看到,对 LLM 推理来说带宽恰恰是最值钱的指标。
把消费级和数据中心两条线的代际放在一起看,节奏其实是对齐的——同一套架构同时喂养两条产品线,只是下放时砍掉了不同的东西:
注意时间线上消费级在 40 系的那个断点:NVLink 从此消失。这不是技术原因,而是产品线划界。
功能阉割
消费卡便宜是有代价的,NVIDIA 在 GeForce 上做的阉割非常精准:
- 互联:3090 是最后一张保留 NVLink 的 GeForce,速度能到 112.5 GB/s,A100 的零头。40 系起物理上去掉了 NVLink 金手指;GPU 间点对点访问(P2P)也在驱动层面被禁用。
- ECC:GeForce 不提供端到端显存 ECC 保护,长时间大负荷运行的位翻转风险自负。
- 许可:GeForce 驱动 EULA 明确限制数据中心部署,早期版本里唯一被豁免的场景是区块链挖矿——条款的意图昭然若揭。
这三条单拎出来都不致命,但合起来划清了消费级和数据中心的分界线:个人随便用,机房别想。
不过这个局面近期发生了转变:NVLink 被某种替代方案绕开了,虽然性能不如 NVLink,但也能实现类似 P2P 的效果。这里的操作在后面的文章会讲,此处先留个悬念。
RTX PRO 工作站
工作站线的前身是 Quadro,2020 年起改名:Ampere 时代叫 RTX A 系(A4000/A5000/A6000),Ada 时代叫 RTX 6000 Ada,Blackwell 时代统一为 RTX PRO 系列,旗舰是 RTX PRO 6000。
产品线沿革
| 代际 | 旗舰 | 显存 |
|---|---|---|
| Ampere | RTX A6000 | 48 GB GDDR6 ECC |
| Ada | RTX 6000 Ada | 48 GB GDDR6 ECC |
| Blackwell | RTX PRO 6000 | 96 GB GDDR7 ECC |
RTX PRO 6000 与 5090 同属 GB202 芯片,但更接近满血:CUDA 核心 24064 对 21760,对应 188 对 170 个 SM;显存从 32G 翻到 96G,带宽同为 1792 GB/s。它有三个版本,区别在功耗和散热形态:
| 版本 | 功耗 | 散热形态 |
|---|---|---|
| 工作站版 | 600W | 主动散热 |
| Max-Q 版 | 300W | 低功耗工作站形态 |
| 服务器版 | 400–600W 可调 | 被动散热,靠机箱风道 |
上市价 8565 美元,受显存涨价影响,2026 年官方价已涨到 16000 美元。
多卡互联上,工作站线的待遇其实和消费级一样:A6000 是最后一张保留 NVLink 的工作站卡,两卡桥接 112.5 GB/s;从 Ada 起 NVLink 被一并砍掉,RTX PRO 6000 多卡只能走 PCIe。想要真正的 NVLink 域,还是得买数据中心线。
溢价来源
同芯片、贵了好几倍的差价买的是什么:
- 显存:48G/96G 靠 PCB 双面贴颗粒实现,这是消费卡 PCB 上根本没有的容量。这个”双面颗粒”的思路后来也被民间学去了,第三篇的魔改显存会讲到。
- ECC:支持端到端显存 ECC 校验与上报,长任务不出错比跑得快重要。
- 驱动与认证:ISV 认证驱动、企业支持、质保含工作站使用场景。
- 形态:服务器版是被动散热双槽卡,可以密集插进机箱靠风道散热——消费卡的开放式风扇做不到这一点。
对纯 AI 负载而言,工作站卡的性价比经常被消费卡吊打;它真正的价值在”既要又要”的场景:需要官方大显存、需要 ECC、需要保修和合规部署三者同时成立的时候。
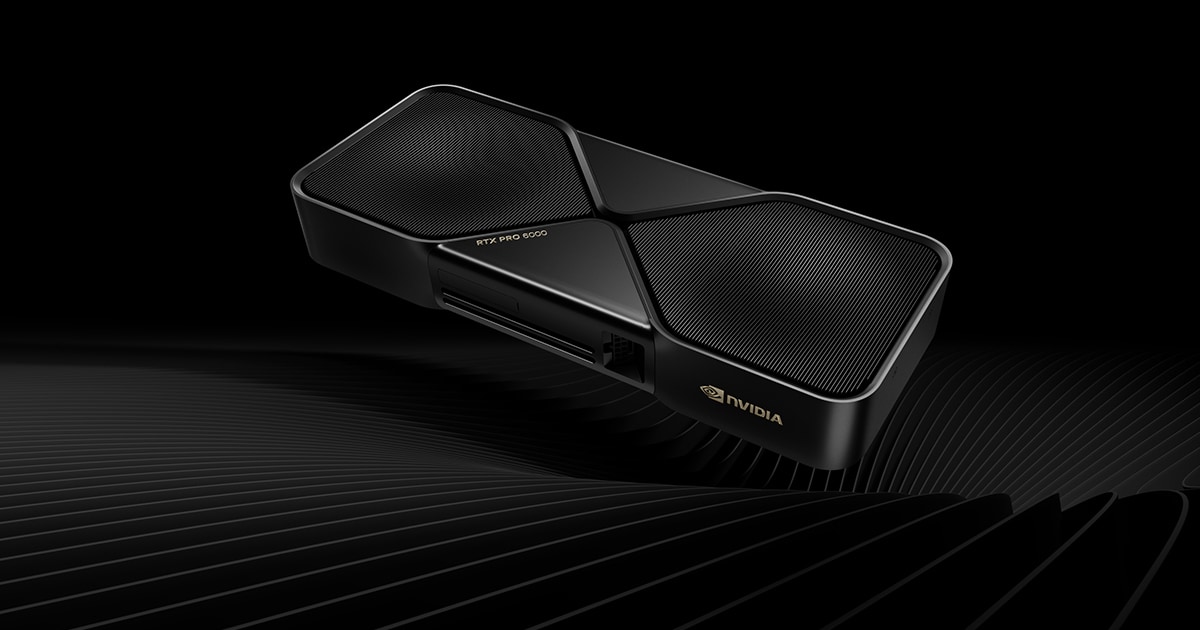
外观上和 5090 的 Founders Edition 几乎一个模子——它们本来就是同一颗 GB202 芯片,贵出来的部分在显存、ECC 和服务条款里,看不见。
数据中心
数据中心线是 NVIDIA 利润最厚的一条线,也是性能上限所在。
训练旗舰
| 型号 | 显存 | 带宽 | NVLink | 备注 |
|---|---|---|---|---|
| A100 | 40/80 GB HBM2/HBM2e | 1.6/2.0 TB/s | 600 GB/s | 上一代的标准答案 |
| H100 SXM | 80 GB HBM3 | 3.35 TB/s | 900 GB/s | 引入 FP8 与 Transformer Engine |
| H200 | 141 GB HBM3e | 4.8 TB/s | 900 GB/s | H100 同算力,显存带宽加大 |
| B200 | 180 GB HBM3e(标称 192 GB) | ~8 TB/s | 1.8 TB/s | 第五代 NVLink,引入 FP4 |
| GB300 | 288 GB HBM3e | ~8 TB/s | 1.8 TB/s | Blackwell Ultra,机柜级出货 |
SXM 与 PCIe
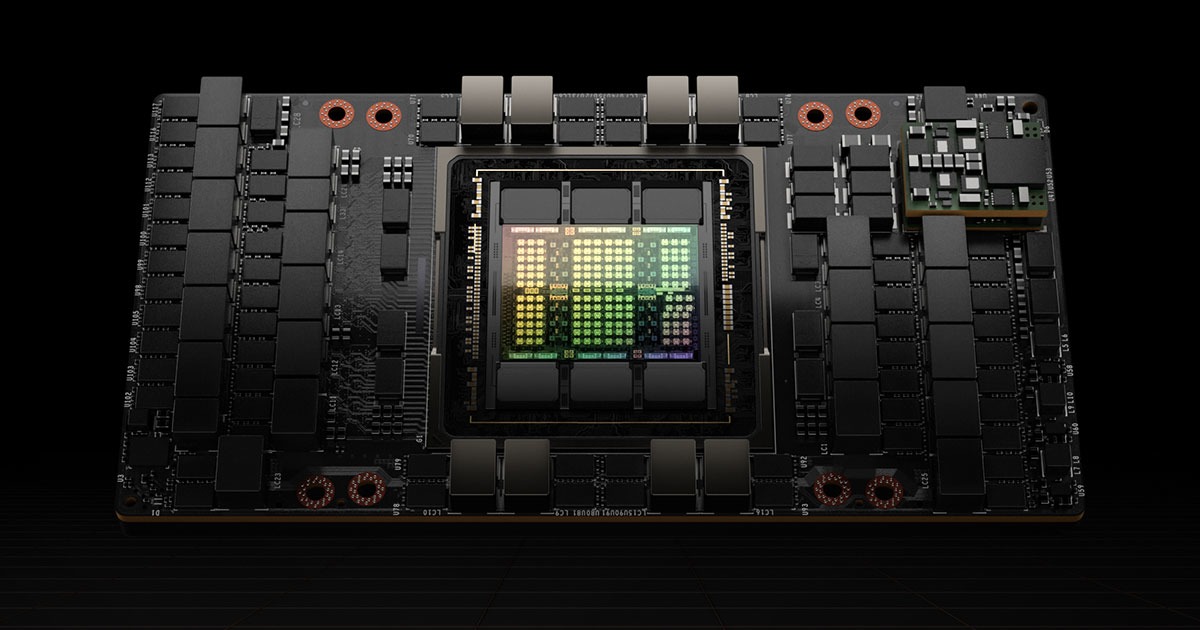
同一颗核心有两种封装:SXM 是焊在基板上的形态,给足功耗和满血 NVLink;PCIe 是标准插卡,功耗和互联都打折——H100 PCIe 只有 350W、NVLink 降到 600 GB/s。买数据中心卡时型号后面的”SXM5”后缀不是装饰,它决定这卡能不能进 NVLink 域。
SXM 模块长这样:一整块基板上焊着 GPU 核心和周围的 HBM 颗粒,没有显示输出、没有风扇,一切都为密度和互联服务。
NVLink 域
多卡互联的分水岭在 NVSwitch:A100/H100 的 SXM 机型通过 NVSwitch 把 8 卡组成一个全互联的 NVLink 域,域内任意两卡直达;出了域就只能走 InfiniBand 跨节点。B200 世代把这个域扩大到了整个机柜——GB200 NVL72 用 72 颗 GPU 加 NVSwitch 组成一个 130 TB/s 的巨型 NVLink 域,对外宣传为”一张 GPU”。
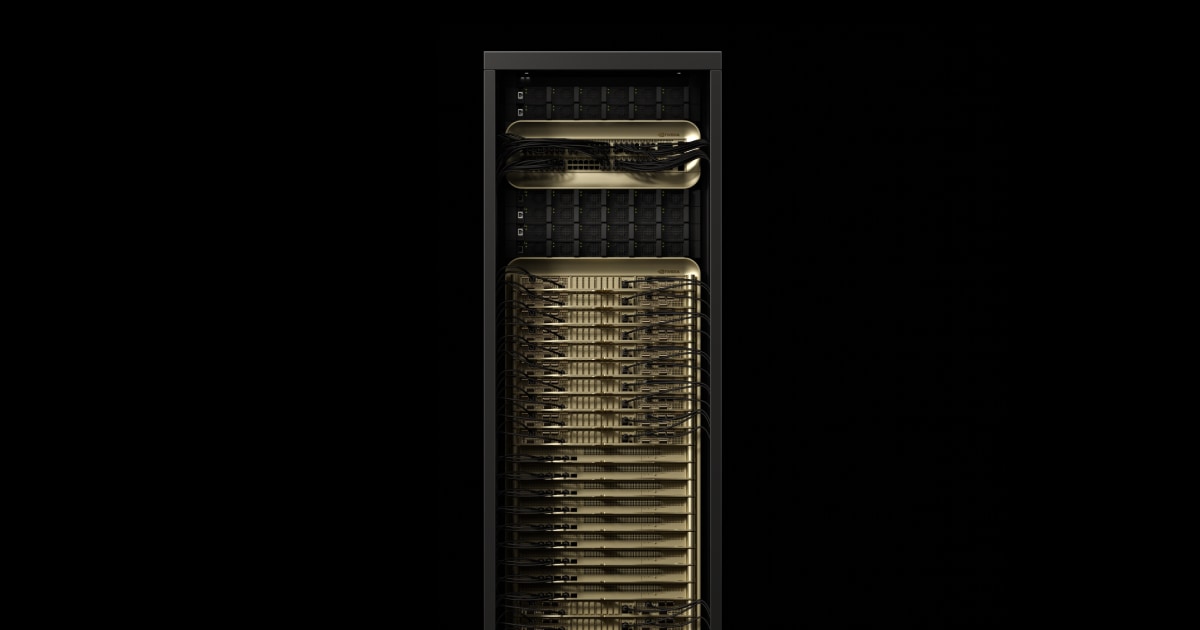
消费级的一台主机最多塞几张卡,而数据中心线的计量单位已经变成了机柜。
推理与边缘
训练旗舰之外还有一条低功耗线,主打推理和边缘部署:
| 型号 | 显存 | 带宽 | 功耗 | 定位 |
|---|---|---|---|---|
| L4 | 24 GB GDDR6 | 300 GB/s | 72W | 半高单槽,2U 服务器能塞七八张,云厂商低端推理的走量款 |
| L40S | 48 GB GDDR6 | 864 GB/s | 350W | Ada 核心的数据中心版,生图和中等模型推理的热门选择 |
| A10 | 24 GB | 600 GB/s | 150W | 上一代定位类似的产品,存量巨大 |
企业特性
数据中心卡的溢价不止在硬件,还在一整套企业特性:ECC 显存、MIG、vGPU 虚拟化授权、机密计算。MIG 能把一张 A100/H100 切成最多 7 个互相隔离的实例,是云厂商分租算力的前提。整机形态上,DGX 是 NVIDIA 自有品牌整机,HGX 是给 OEM 的基板方案。这些特性单看都不起眼,但没有它们就没法把卡卖给云厂商和企业机房。
出口特供
出口管制催生了一条不在官方 roadmap 上的产品线:特供中国的阉割版。
特供型号
| 型号 | 基于 | 阉割方式 |
|---|---|---|
| A800 | A100 80G | NVLink 600 → 400 GB/s |
| H800 | H100 SXM | NVLink 900 → 400 GB/s |
| H20 | Hopper 架构 | 算力砍到 148 TFLOPS FP16,保留 96G HBM3 + 4.0 TB/s + NVLink 900 |
| RTX 4090D | RTX 4090 | CUDA 核心 16384 → 14592 |
| RTX 5090D | RTX 5090 | AI 算力 3352 → 2375 TOPS |
| RTX 5090D v2 | RTX 5090D | 显存 32G/512bit → 24G/384bit,带宽 1792 → 1344 GB/s |
阉割方式
三代特供正好演示了三种阉割思路:
- 砍互联:A800/H800,卡间带宽受限,多卡训练效率打折。
- 砍算力:H20,峰值算力不足 H100 的两成,但显存、带宽、NVLink 全部保留。
- 砍显存/AI 算力:5090D 系列。
H20 是最值得细品的一张:管制规则卡的是算力密度,NVIDIA 就把算力砍到底、把带宽和互联原样留下——恰好凑成一张推理特化卡:LLM 推理吃带宽不吃算力,原因下篇讲。所以 H20 在中国市场一度供不应求,禁令几收几放,堪称出口管制和产品定义博弈的活教材。
特殊形态
还有两类卡不在标准产品线上,但在 AI 圈子里存在感不低。
DGX Spark
NVIDIA 官方出的桌面盒子:GB10 超级芯片,CPU 和 GPU 共享 128 GB LPDDR5x 统一内存,整机三千多美元。128G 容量可以装下很多中端模型,但带宽只有约 273 GB/s——前面说过带宽决定推理速度,所以它的定位是能跑大模型的开发机,不是跑得快的那种。两台之间可以用 ConnectX-7 直连组成小集群。
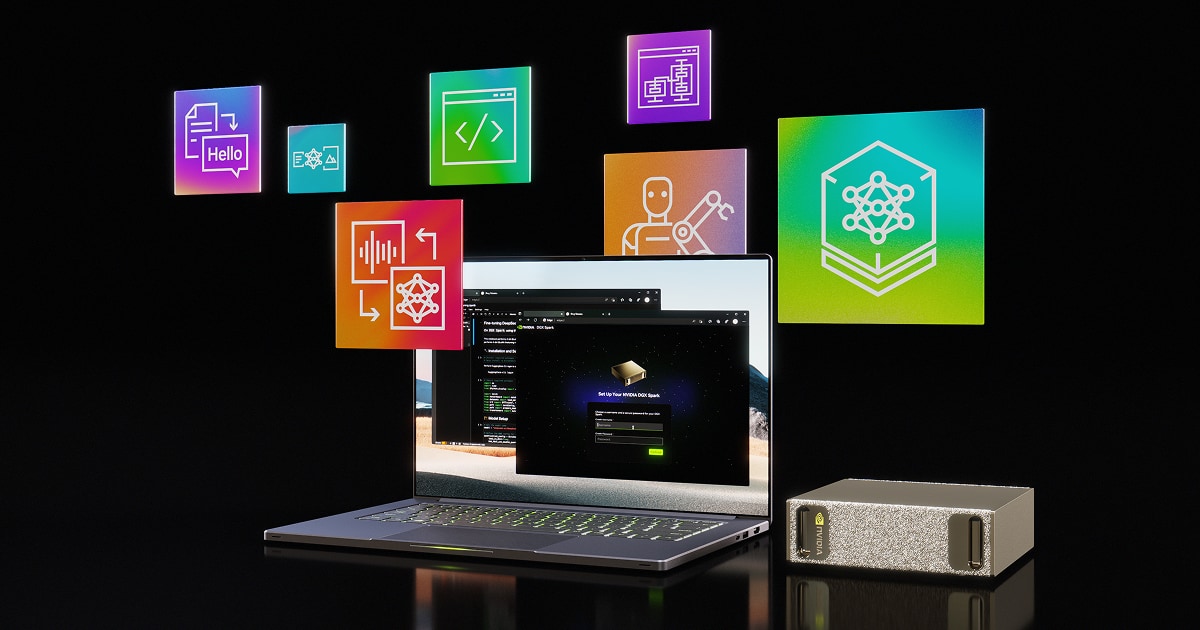
实物尺寸相当小——右边那个小方块就是全部算力,形态上更像一台 Mac mini 而不是工作站。
既然像 Mac,就免不了和 Mac Studio 比,而结果基本是完败:同价位的 M4 Max 给到 128G 统一内存和 546 GB/s 带宽,容量一样、带宽翻倍;要更大显存还有 M3 Ultra 的 512G、819 GB/s。Spark 真正的卖点只剩下 CUDA 本身——它是给”开发目标在 NVIDIA 生态”的人准备的开发机;如果只想要一台能跑大模型的桌面盒子,Mac Studio 是更划算的那个。
涡轮与服务器版
消费卡官方只有开放式风扇形态,插不了多卡机箱,于是市场上存在一条灰色供应链:OEM 流出的涡轮版 4090/5090、以及第三方换涡轮散热的改装卡。单槽或双槽涡轮往外直排热量,是往 4U 机箱里塞 8 张消费卡的前提。这些卡没有官方保修,多卡互联的限制也一样不少——但确实存在,而且构成了后面偏方篇的物理基础。
结语
把整条产品线铺开看,NVIDIA 的卡其实是在显存容量、显存带宽、互联带宽这三个维度上拉开的光谱:消费级卡在三个维度上依次封顶,32G、1.8 TB/s、无 NVLink;工作站卡用显存和合规性补位,数据中心卡在带宽和互联维度上不设上限,一直到 NVL72 这种”72 卡一张 GPU”的极端形态。
把前面提到的代表卡按「容量 × 带宽」两个维度画在一张图上,光谱的分层会更直观:
几个读图要点:GeForce 密集挤在左下角,容量小、带宽低;数据中心卡沿右上方向排开。DGX Spark 是个离群点——容量冲上去了,带宽却还停在入门级;H20 也是异类,带宽和 NVLink 都在高位,只有算力被砍——它的位置印证了”推理特化”的设计。下一篇会看到,这张图上的横轴比纵轴更能决定 LLM 推理体验。
看完谱系,下一个问题自然是:规格表上这些数字到底哪个重要、怎么读。这是下一篇的主题。
参考资料
- Which GPU(s) to Get for Deep Learning — Tim Dettmers
- Epoch AI — Machine Learning Hardware Dataset
- NVIDIA GPU Generations — AI Infrastructure Knowledge Base
- NVLink — Wikipedia
- RTX PRO 6000 Blackwell Series — NVIDIA
- NVIDIA Blackwell Architecture Datasheet
- NVIDIA RTX 5090D V2 specs — Tom’s Hardware
- RTX 5090 D v2 — NVIDIA 中国