
前言
本文是本站 LLM 系列的第一篇文章,我们将直接从 Transformer 开始介绍,带你快速了解目前几乎所有 LLM、Agent 的底层核心模型是如何实现的。
Transformer 最初由 Google Brain 与 Google Research 团队在论文 Attention Is All You Need 提出,起初用于解决翻译问题。 Transformer 以更低的训练成本和更高的性能在当时成为了翻译领域的 SOTA,随后又被用于解决 NLP 领域的各种问题,且都具有极佳的表现。 本文将主要以这篇论文的 Transformer 进行介绍,后面都以“原始论文”代指。
本文假设读者已经有一定基础,如果你是纯小白,阅读本文可能会比较困难。不过我并不建议花费大量时间去补充基础,因为如果遇到不懂的概念,你随时可以请教AI,这将会为你节省很多时间。
本文主要聚焦 Transformer 模型的数学表示以及其代码实现,也就是说,我们会通过数学公式来表示 Transformer 各个模块的计算细节,并通过代码对其进行实现。
接下来,让我们进入正文。
模型架构
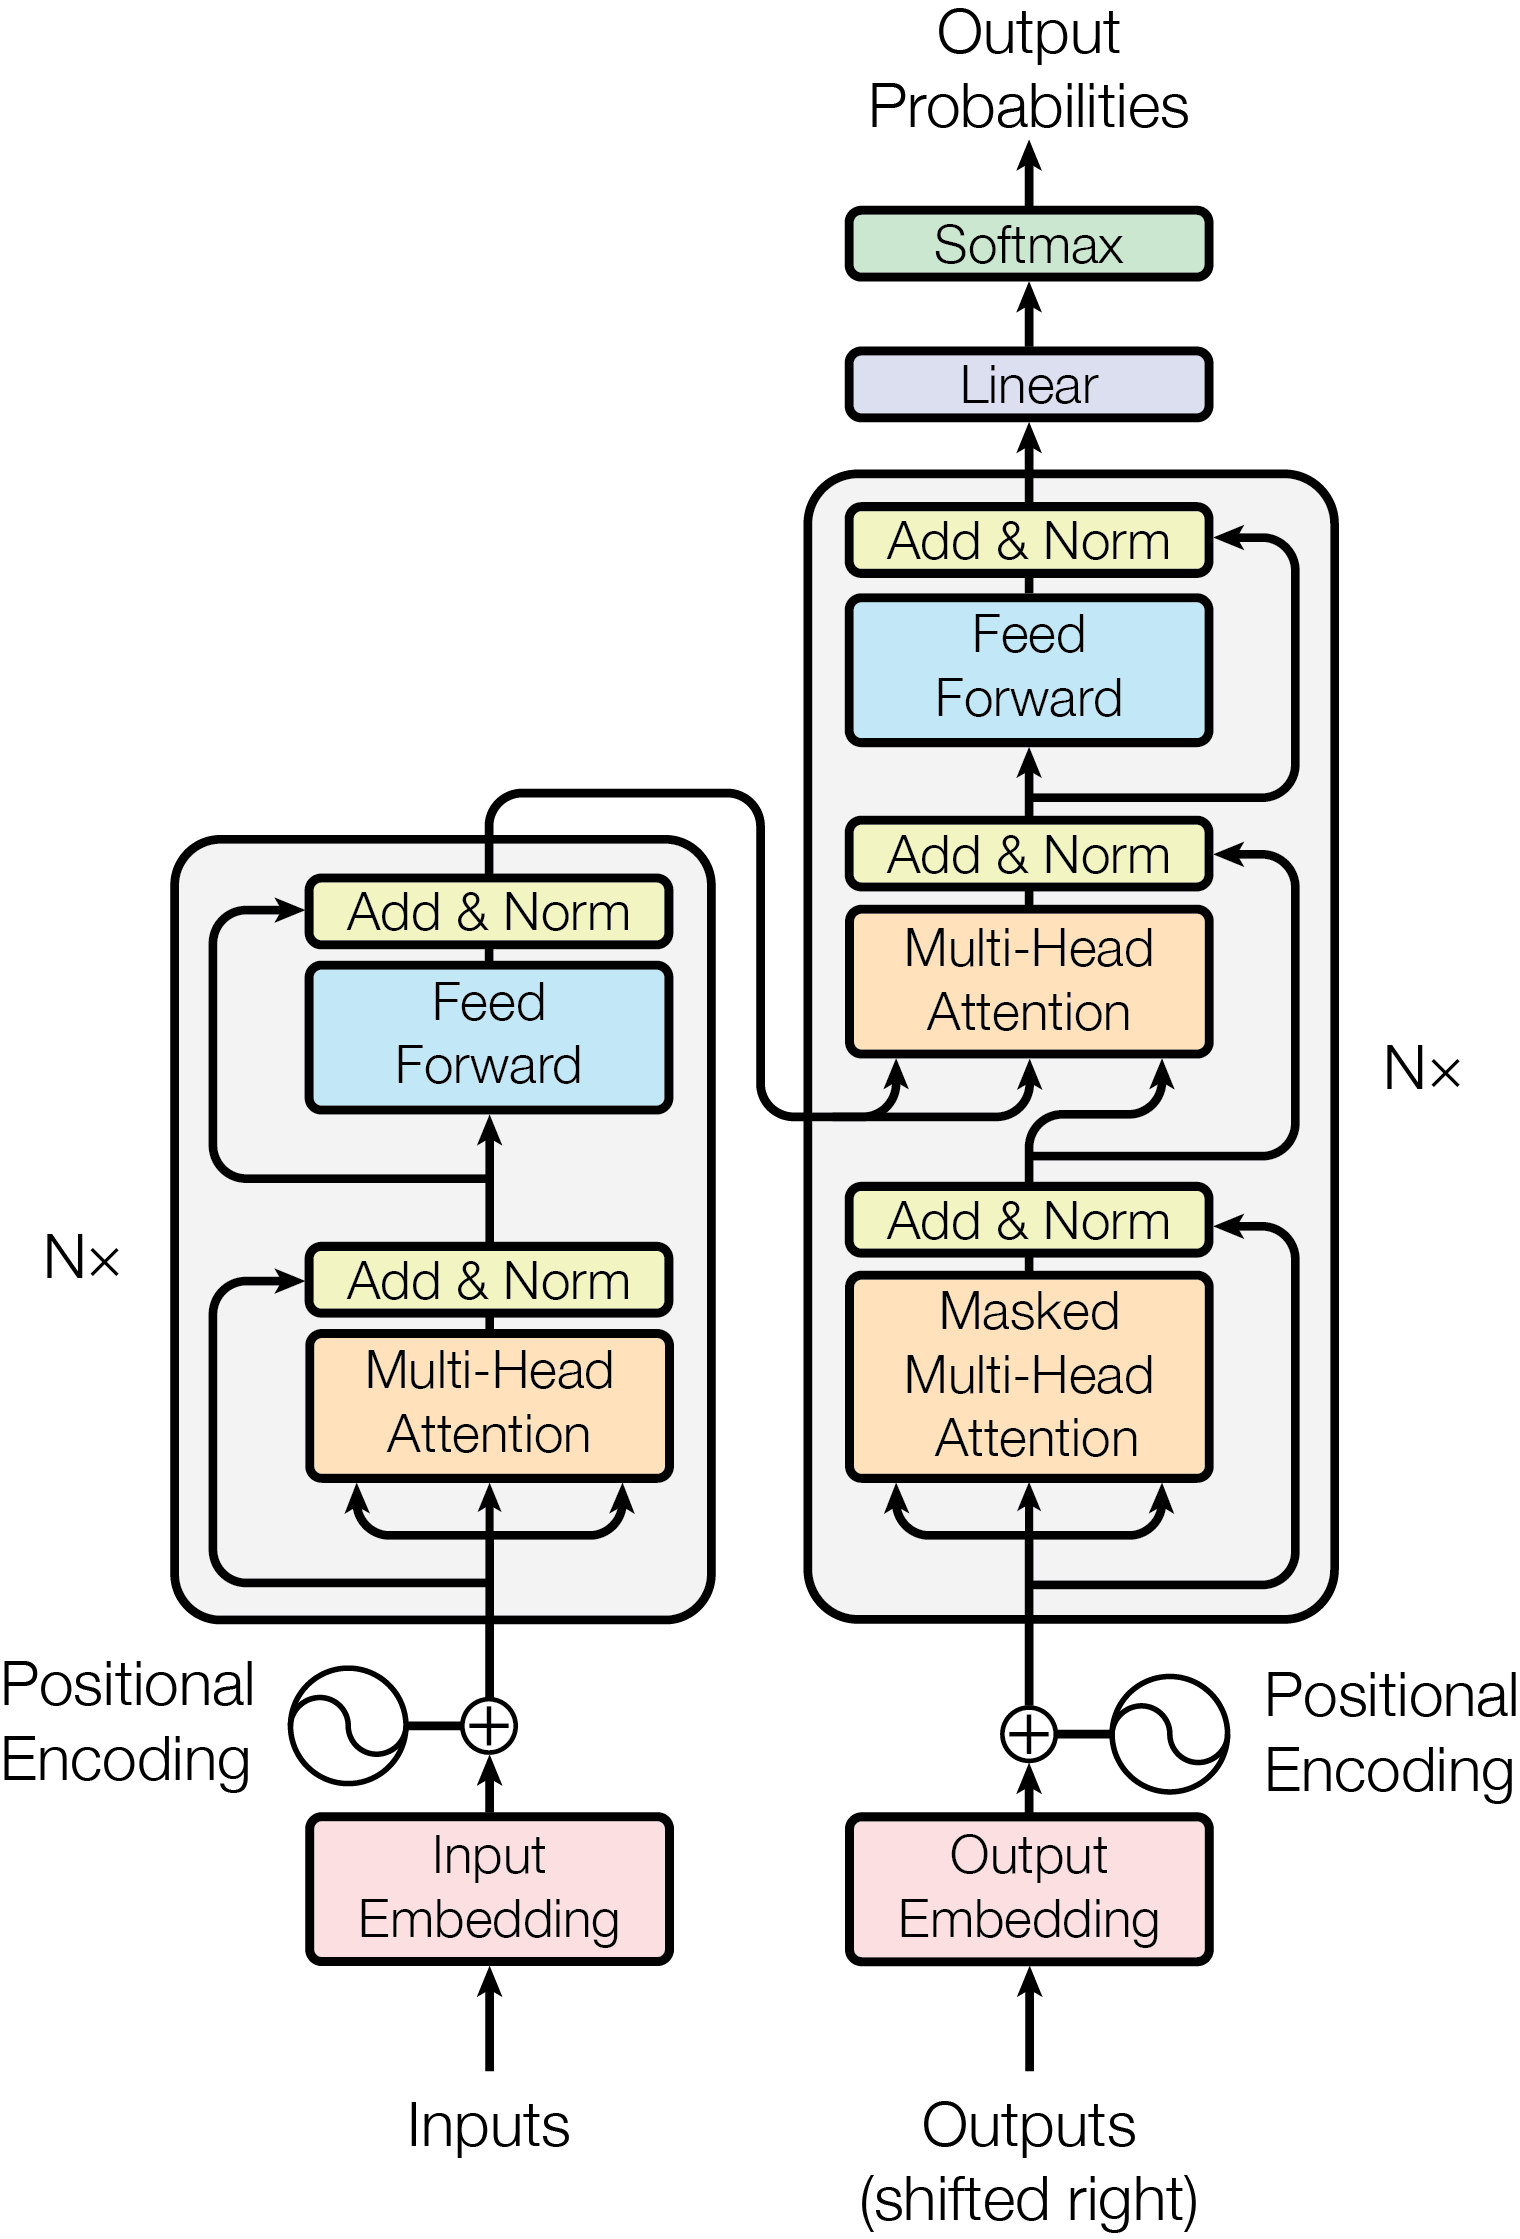
Transformer 使用了 Encoder-Decoder 架构,这是当时解决 seq2seq 问题的经典架构。
接下来我们将分为 Encoder 和 Decoder 进行介绍,然后再补充输入侧和输出侧的细节。其中 Decoder 有许多基本计算模块和 Encoder 是相同的,因此不重复介绍相同的部分。
Encoder
标准 Transformer 的 Encoder 由 6 个完全相同的 Encoder Block 堆叠而成,每一层的输入是上一层的输出。 每个 Block 包含两个 SubLayer:Multi-Head Attention (MHA) 和 Feed-Forward Network (FFN)。 每个子层都采用 Residual Connection,然后接 LayerNorm。 此外,在训练阶段,每个 SubLayer 的输出在进入残差连接之前会先经过 Dropout。
由于两个子层结构相同,都是“Dropout、残差、LayerNorm”的组合,只是内部函数 不同。因此可以先将子层抽象为一个通用形式:
其中 分别为 MHA 和 FFN,那么整个 Encoder Block 的计算过程可以表示为两个子层的复合:
接下来将展开讲解各个子层的计算细节。
MHA
MHA 可以说是整个 Transformer 的核心,其特点在 Self-Attention 和 Multi-Head 两部分。
Self-Attention
Self-Attention 指的是一组 Query、Key 和 Value 都通过同一个输入 计算获得。 具体而言,同一个输入 通过矩阵 、、 分别进行线性变换,从而得到 、、:
由于序列中的每个 相互独立,我们可以将输入序列拼接成矩阵 ,其中 为序列长度。 通过 GPU 直接对矩阵 进行运算,从而大幅提高计算效率:
在上述矩阵运算中的权重矩阵 、、 与之前对单个 进行计算时的参数是一样的。
得到 Query、Key、Value 后,我们就可以计算注意力分数和最终的注意力加权和了。 自注意力的意义在于捕捉序列内不同位置之间的依赖关系,因此我们跳过对单个输入的讨论,直接从矩阵形式开始说明 Transformer 如何使用点积计算注意力分数:
其中 是 和 的特征维度,由于二者要进行点积运算,二者的特征维度必须相同。
使用 是为了把注意力分数转化为一组非负且和为 1 的权重,使得注意力输出是 Value 的加权平均,从而符合“注意力”的语义。
公式中还除以了 ,这一项是由于点积运算会导致结果的方差变为原来的 倍, 所以这里除以标准差 可以抵消 对点积结果量级的影响,让 logits 的数值范围保持稳定。 这么做可以避免 进入饱和区,让模型的训练更稳定。
得到注意力分数后,就可以和 Value 矩阵 进行相乘了。
最终我们得到的就是经过注意力分数加权计算的注意力加权和。
def attention( query: torch.Tensor, # [batch, n, d_k] key: torch.Tensor, # [batch, n, d_k] value: torch.Tensor, # [batch, n, d_v] mask: torch.Tensor | None = None # [n, n] or [batch, n, n]) -> torch.Tensor: d_k = query.size(-1) scores = query @ key.transpose(-2, -1) / math.sqrt(d_k) # [batch, n, n] if mask is not None: scores = scores + mask.to(scores.dtype) weights = F.softmax(scores, dim=-1) return weights @ value # [batch, n, d_v]此处的 mask 参数会在 Masked Attention 一节中详细解释,在此之前可以忽略。
Multi-Head
“多头”指的是在计算 、、 矩阵时,使用多组独立的 、、 矩阵对输入进行计算,每一组就是一个头,其基本思想是希望每个头负责提取不同类型的特征。
其中 表示头的序号,输入 的特征维度为 ,有 个头, 和 的特征维度为 , 的特征维度是 。 三个投影矩阵 ,,。
原始论文设 ,这样 组 、 沿特征维度拼接后就得到特征维度为 的矩阵。 这么做的目的其实是为了保证对于取不同 的模型,其参数量、计算量都基本一致,这样在消融实验中可以更好地突出头数量 本身的作用。
每个头独立地做一次自注意力计算,得到各自的输出:
然后将所有头的输出沿特征维度拼接,并通过线性层 映射回 :
其中每个 的特征维度为 ,拼接后特征维度为 ,,保证输出与后续残差连接的维度一致。这里的 在原始论文中是存在的,即便在单头情况下也保留。
原始论文设 ,这主要是出于和 一样的原因,不过这不是强制的,因为最后一层的线性变换依然可以保证输出为 。
class MHA(nn.Module): def __init__(self, d_model: int, num_heads: int) -> None: super().__init__() assert d_model % num_heads == 0 self.d_model = d_model self.num_heads = num_heads self.d_k = self.d_model // self.num_heads self.d_v = self.d_model // self.num_heads # d_v could be simplified as d_k here, but I want to keep it clear self.w_q = nn.ModuleList([nn.Linear(self.d_model, self.d_k, bias=False) for _ in range(self.num_heads)]) self.w_k = nn.ModuleList([nn.Linear(self.d_model, self.d_k, bias=False) for _ in range(self.num_heads)]) self.w_v = nn.ModuleList([nn.Linear(self.d_model, self.d_v, bias=False) for _ in range(self.num_heads)]) self.w_o = nn.Linear(self.d_v * self.num_heads, self.d_model, bias=False)
def forward(self, query: torch.Tensor, key: torch.Tensor, value: torch.Tensor, mask: torch.Tensor | None = None) -> torch.Tensor: heads = [attention(self.w_q[i](query), self.w_k[i](key), self.w_v[i](value), mask) for i in range(self.num_heads)] return self.w_o(torch.cat(heads, dim=-1))FFN
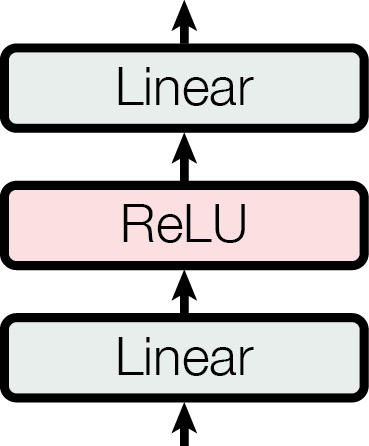
FFN 本质就是一个双层 MLP,它对序列中每个位置独立地应用同一个网络,因此不进行跨位置的信息混合。 由于这种 FFN 在每次前向传播中会激活全部参数,因此后来也被称为 Dense FFN,与之相对的是后来提出的 MoE 架构。 关于 MoE 我会在以后的文章讨论,这里就不展开了。
此处直接给出 FFN 层的计算公式:
其中 ,, 原始论文中取 ,即先升维再降维。
class FFN(nn.Module): def __init__(self, d_model: int, d_ff: int) -> None: super().__init__() self.d_model = d_model self.d_ff = d_ff self.mlp = nn.Sequential( nn.Linear(d_model, d_ff), nn.ReLU(), nn.Linear(d_ff, d_model), )
def forward(self, x: torch.Tensor) -> torch.Tensor: return self.mlp(x)Decoder
Decoder 和 Encoder 类似,也是由多个 Block 堆叠组成。一个 DecoderBlock 含有三个子层:Masked Multi-Head Attention、Cross Attention、FFN,每个子层同样采用残差连接、Dropout 和 LayerNorm。
DecoderBlock 本质上仍然是由 MHA 和 FFN 组成,其中 FFN 与 Encoder 完全一致。 沿用 Encoder 中的 SubLayer 抽象,DecoderBlock 可以表示为三个子层的复合:
Transformer 总共堆叠了 6 个 DecoderBlock。
关键区别在于 Decoder 的 MHA 具有两个特点:Masked Attention 和 Cross Attention。
Masked Attention
在训练阶段,我们通常采用 teacher forcing,也就是一次性把整个目标序列喂给 Decoder,让它预测每个位置的下一个 token。 此时位置 的 Query 会与所有位置的 Key 计算注意力分数,包括 这些未来位置。 如果不加处理,模型就能直接“看到”未来的 token,从而失去自回归生成的能力,训练和推理也会不一致。
为了避免这种情况,需要在计算注意力分数后,将未来位置的分数设为一个极大的负数,通常是 ,这样经过 softmax 后这些位置的权重就变为 0。
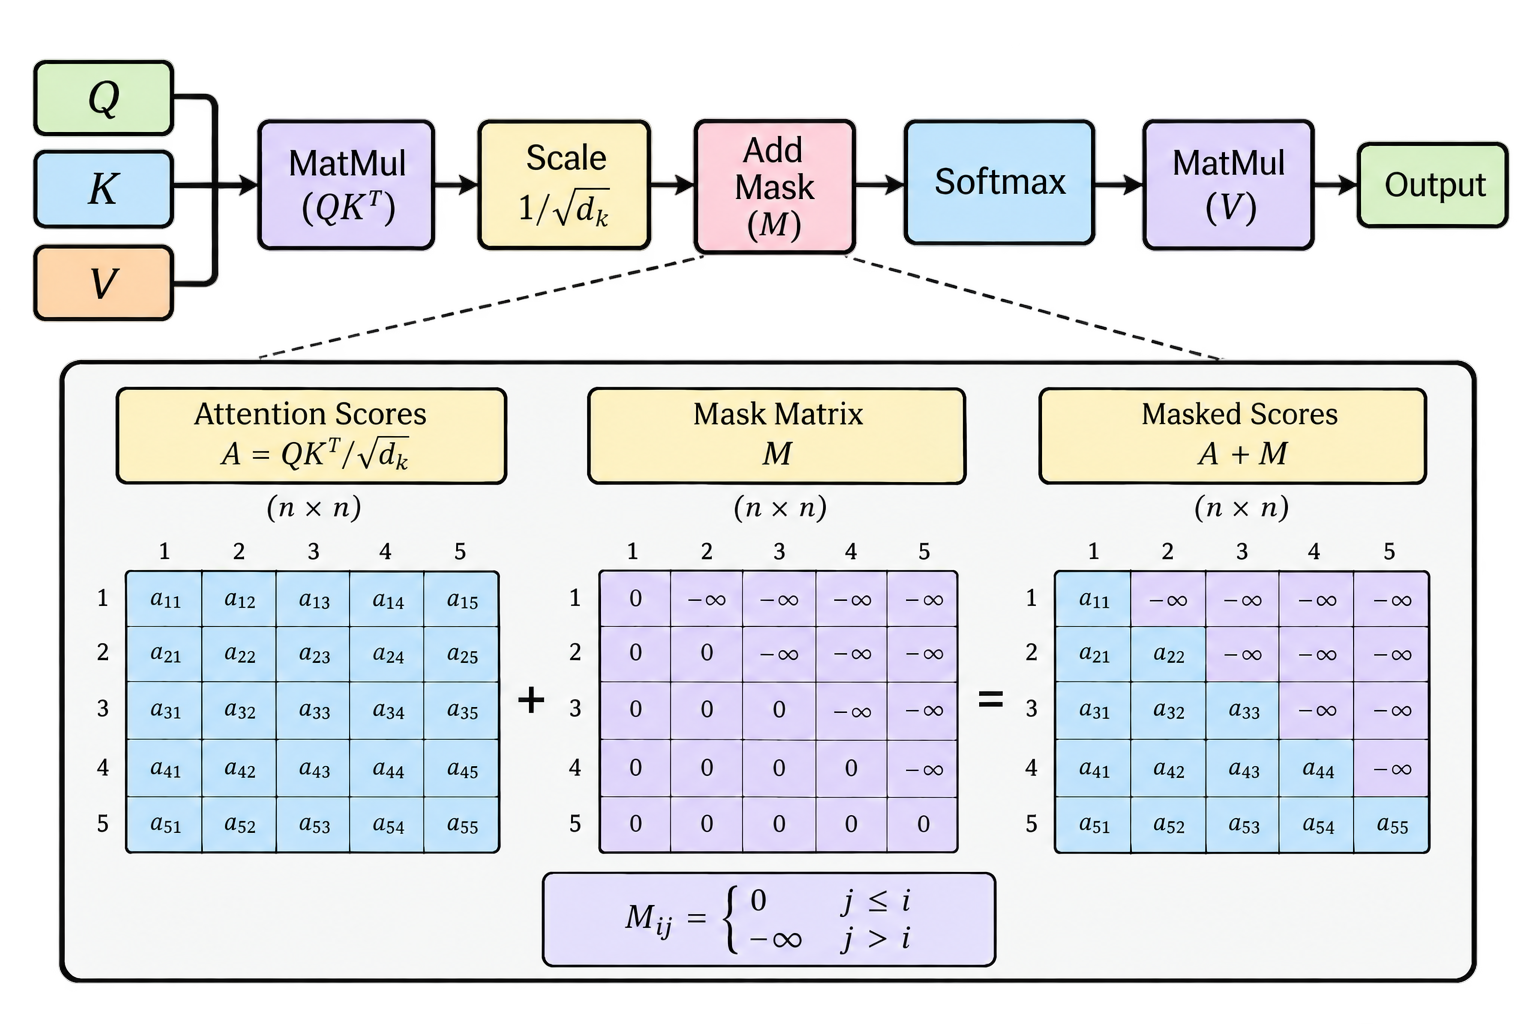
设注意力分数矩阵为 。定义掩码矩阵 :
则 Masked Attention 可以表示为:
_NEG_INF = float("-inf")
def causal_mask(size: int, device: torch.device | None = None) -> torch.Tensor: i = torch.arange(size, device=device).unsqueeze(1) # [n, 1] j = torch.arange(size, device=device).unsqueeze(0) # [1, n] return torch.where(j > i, _NEG_INF, 0.0) # [n, n]causal_mask 就是用于生成掩码矩阵 的函数,这也解释了前文代码中出现的 mask 参数。
不过在实际训练中,一个 batch 里的序列长度往往不同,短的序列会用 padding token 补齐,这些 padding 位置同样不应参与注意力计算。因此除了 causal mask,还需要一个 padding mask:
def padding_mask(pad: torch.Tensor) -> torch.Tensor: return torch.where(pad.bool(), _NEG_INF, 0.0).unsqueeze(1) # [batch, 1, n]padding_mask 返回的形状为 [batch, 1, n],加到 [batch, n, n] 的 scores 上时会广播到所有 Query 位置,这样 pad 位置的 Key 就不会被任何 Query 注意到。
Cross Attention
前面我们在 Self-Attention 中默认三个输入都来自同一个 。 事实上,注意力机制并不要求三者同源,只要经过投影后的 和 维度一致即可。 因此可以把 MHA 推广为接受三个输入的形式:
其中每个头的输出为:
于是 Self-Attention 就是 的特例。
Cross Attention 则把三个输入拆开: 来自 Decoder 当前状态 , 和 来自 Encoder 输出 ,即:
展开后:
其中 ,,。
Decoder 在生成每个 token 时,需要参考完整的输入序列。Query 来自 Decoder,表示“当前要生成什么”;Key 和 Value 来自 Encoder,表示“输入提供了哪些信息”。
计算上,Cross Attention 与普通 MHA 完全一致,唯一的区别就是 和 、 的来源不同。
线性分类头
Decoder 最后一层的输出经过一个线性层和 softmax,就得到了下一个 token 的概率分布:
其中 是最后一层 DecoderBlock 的输出; , 是词表大小; ,每一行对应一个位置上所有 token 的概率分布。
训练时,取 中对应目标 token 的概率计算交叉熵损失。 推理时,原始论文使用 beam search,beam size 取 4,即同时保留概率最高的 4 条候选序列,最终选择整体概率最高的一条作为输出。
不难发现,在词表 非常大时, 的参数量会十分庞大,而这个问题其实是有办法缓解的。
第一种方式是通过加一层线性变换,先将 Decoder 最后一层的输出特征维度压缩,得到一个更小的向量,然后再进行最终的线性变换。这种方式的优点是实现简单,不过压缩会带来一定的性能损失,实际应用中较少使用。
另一种方式是使用 weight tying,即权重绑定,即让 与输入的 embedding 层的权重矩阵共享参数:,其中 是 embedding 矩阵。 这样可以省去对线性分类头参数的独立学习,减少模型参数量。这种方式对模型性能几乎没有影响,在输入输出词表一致的任务中已成为标准做法,原始论文也采用了这种方式。
class LinearClassifier(nn.Module): def __init__(self, d_model: int, vocab_size: int, weight: torch.Tensor | None = None) -> None: super().__init__() self.classifier = nn.Linear(d_model, vocab_size, bias=False) if weight is not None: self.classifier.weight = weight
def forward(self, x: torch.Tensor) -> torch.Tensor: return self.classifier(x) # [batch, n, d_model] -> [batch, n, vocab_size]在 PyTorch 中,nn.Linear 和 nn.Embedding 的权重形状都是 [V, d_model],因此代码里可以直接共享同一个参数,无需显式转置。
Embedding
token 本身是离散的,通常用整数 id 表示,这些 id 之间没有数值上的语义关系。而模型需要的是连续的、具有语义的输入,为此需要通过 embedding 层将离散的输入变换为连续向量。
具体做法是维护一个可学习的嵌入矩阵 ,其中 是词表大小。对输入的 token id 做 one-hot 编码后,与 相乘,并乘以 以平衡嵌入和位置编码的量级:
由于 one-hot 向量只有一位为 1,这个矩阵乘法实际上等价于按 id 查表,因此工程实现中直接用 nn.Embedding 完成:
class Embedding(nn.Module): def __init__(self, vocab_size: int, d_model: int) -> None: super().__init__() self.d_model = d_model self.w_e = nn.Embedding(vocab_size, d_model) nn.init.normal_(self.w_e.weight, mean=0.0, std=d_model ** -0.5)
def forward(self, x: torch.Tensor) -> torch.Tensor: return self.w_e(x) * math.sqrt(self.d_model)这里显式把嵌入矩阵初始化为 ,是因为权重绑定后,嵌入矩阵同时承担嵌入和输出投影两个角色, 需要控制其初始化尺度,否则初始 logits 的量级会过大,导致训练初期 loss 异常。
位置编码
最后我们讲一下位置编码。
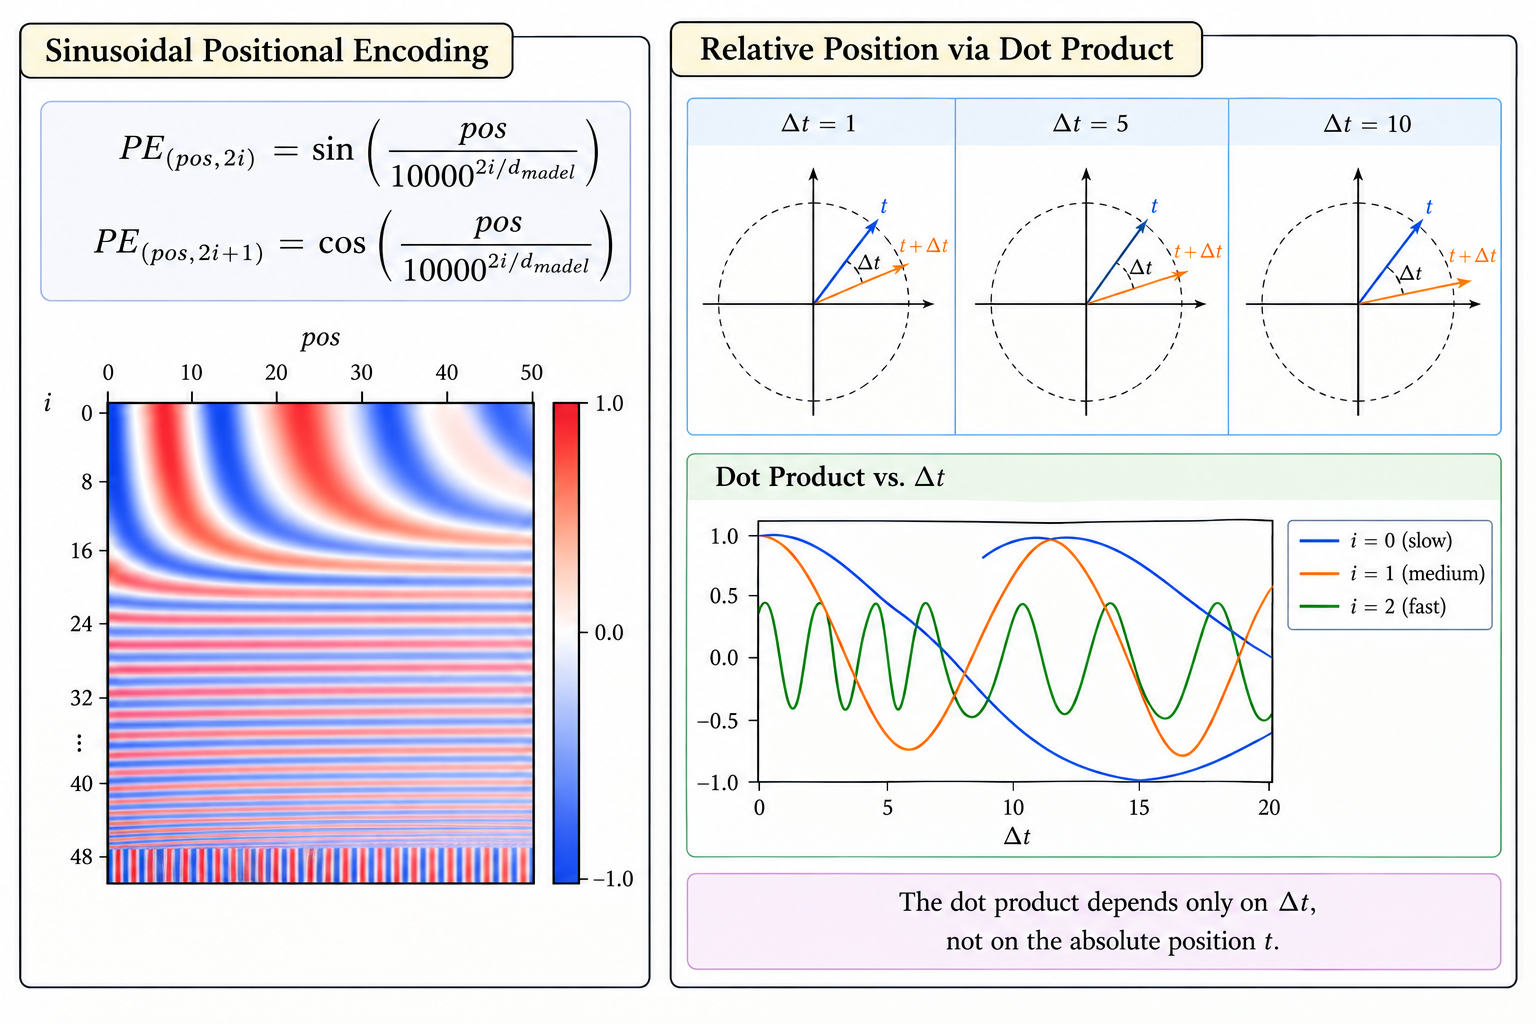
由于 Transformer 的自注意力机制本身对序列中 token 的顺序是不敏感的,即打乱输入序列的顺序,计算结果也不会改变。因此,我们需要额外为每个 token 注入位置信息。原始论文采用了一种基于正弦和余弦函数的固定位置编码:
其中 是 token 在序列中的位置,从 0 开始计数; 是维度索引,取值范围为 , 和 分别对应偶数维度和奇数维度; 是词嵌入维度。
这种编码方式的一个重要性质是:它使得模型能够更容易地捕捉相对位置信息。考虑两个位置 和 ,它们在某个维度上的编码可以看作一个二维向量 和 ,其中 。对这两个向量做点积:
可以看到,点积的结果只与相对位置 有关,而与绝对位置 无关。这意味着模型可以通过这种编码自然地学习到“两个 token 之间相隔多远”这样的相对位置关系,这对于自然语言处理是非常重要的。
class PositionEncoding(nn.Module): def __init__(self, d_model: int, max_len: int = 5000) -> None: super().__init__() assert d_model % 2 == 0 self.d_model = d_model self.max_len = max_len # cache length self.register_buffer("cache", self.encode(0, self.max_len), persistent=False)
def encode(self, start: int, end: int, device: torch.device | None = None) -> torch.Tensor: n = end - start pos = torch.arange(start, end, dtype=torch.float32, device=device).unsqueeze(-1) # [n, 1] i = torch.arange(0, self.d_model, 2, dtype=torch.float32, device=device).unsqueeze(0) # [1, d_model / 2] div = torch.exp(-math.log(10000) * i / self.d_model) # [1, d_model / 2] position_encoding = torch.zeros(n, self.d_model, device=device) # [n, d_model] position_encoding[:, 0::2] = torch.sin(pos * div) position_encoding[:, 1::2] = torch.cos(pos * div) return position_encoding
def forward(self, x: torch.Tensor) -> torch.Tensor: n = x.size(-2) if n <= self.max_len: return x + self.cache[:n].to(x.dtype) pos_encoding = torch.zeros_like(x) pos_encoding[:, :self.max_len] = self.cache.to(x.dtype) pos_encoding[:, self.max_len:] = self.encode(self.max_len, n, device=x.device).to(x.dtype) return x + pos_encoding其中位置编码的 cache 设置了参数 persistent=False,这是为了避免保存 checkpoint 的时候把位置编码的缓存也保存起来,节省空间。
完整代码实现
接下来,我们将基于前文已有的代码实现完整的 Transformer。
Encoder
class EncoderBlock(nn.Module): def __init__(self, d_model: int, num_heads: int, d_ff: int, dropout: float = 0.1) -> None: super().__init__() self.mha = MHA(d_model, num_heads) self.ln1 = nn.LayerNorm(d_model) self.ffn = FFN(d_model, d_ff) self.ln2 = nn.LayerNorm(d_model) self.dropout = nn.Dropout(dropout)
def forward(self, x: torch.Tensor, mask: torch.Tensor | None = None) -> torch.Tensor: residual = x x = self.mha(x, x, x, mask) x = self.dropout(x) x = self.ln1(x + residual) residual = x x = self.ffn(x) x = self.dropout(x) x = self.ln2(x + residual) return x
class Encoder(nn.Module): def __init__(self, num_layers: int, d_model: int, num_heads: int, d_ff: int, dropout: float = 0.1): super().__init__() self.blocks = nn.ModuleList([ EncoderBlock(d_model, num_heads, d_ff, dropout) for _ in range(num_layers) ])
def forward(self, x: torch.Tensor, mask: torch.Tensor | None = None) -> torch.Tensor: for block in self.blocks: x = block(x, mask) return xDecoder
class DecoderBlock(nn.Module): def __init__(self, d_model: int, num_heads: int, d_ff: int, dropout: float = 0.1) -> None: super().__init__() self.masked_mha = MHA(d_model, num_heads) self.ln1 = nn.LayerNorm(d_model) self.cross_mha = MHA(d_model, num_heads) self.ln2 = nn.LayerNorm(d_model) self.ffn = FFN(d_model, d_ff) self.ln3 = nn.LayerNorm(d_model) self.dropout = nn.Dropout(dropout)
def forward(self, y: torch.Tensor, h: torch.Tensor, self_mask: torch.Tensor | None = None, cross_mask: torch.Tensor | None = None) -> torch.Tensor: residual = y y = self.masked_mha(y, y, y, self_mask) y = self.dropout(y) y = self.ln1(y + residual) residual = y y = self.cross_mha(y, h, h, cross_mask) y = self.dropout(y) y = self.ln2(y + residual) residual = y y = self.ffn(y) y = self.dropout(y) y = self.ln3(y + residual) return y
class Decoder(nn.Module): def __init__(self, num_layers: int, d_model: int, num_heads: int, d_ff: int, dropout: float = 0.1): super().__init__() self.blocks = nn.ModuleList([ DecoderBlock(d_model, num_heads, d_ff, dropout) for _ in range(num_layers) ])
def forward(self, y: torch.Tensor, h: torch.Tensor, self_mask: torch.Tensor | None = None, cross_mask: torch.Tensor | None = None) -> torch.Tensor: for block in self.blocks: y = block(y, h, self_mask, cross_mask) return yTransformer
class Transformer(nn.Module): def __init__( self, d_model: int, max_len: int, num_layers: int, num_heads: int, d_ff: int, vocab_size: int, dropout: float = 0.1 ) -> None: super().__init__() self.embedding = Embedding(vocab_size, d_model) self.pos_encoder = PositionEncoding(d_model, max_len) self.dropout = nn.Dropout(dropout) self.encoder = Encoder(num_layers, d_model, num_heads, d_ff, dropout) self.decoder = Decoder(num_layers, d_model, num_heads, d_ff, dropout) self.classifier = LinearClassifier(d_model, vocab_size, self.embedding.w_e.weight)
def forward( self, src: torch.Tensor, # [batch, src_len] tgt: torch.Tensor, # [batch, tgt_len] src_pad: torch.Tensor | None = None, # [batch, src_len], 1 表示 padding tgt_pad: torch.Tensor | None = None, # [batch, tgt_len], 1 表示 padding ) -> torch.Tensor: src = self.dropout(self.pos_encoder(self.embedding(src))) tgt = self.dropout(self.pos_encoder(self.embedding(tgt)))
src_mask = padding_mask(src_pad) if src_pad is not None else None
causal = causal_mask(tgt.size(1), device=tgt.device) if tgt_pad is not None: tgt_mask = causal + padding_mask(tgt_pad) # [batch, tgt_len, tgt_len] else: tgt_mask = causal
h = self.encoder(src, src_mask) # [batch, src_len, d_model] z = self.decoder(tgt, h, tgt_mask, src_mask) # [batch, tgt_len, d_model] return self.classifier(z) # logits: [batch, tgt_len, vocab_size]最终的输出是 logits,而根据公式来说是要经过 的,这里为什么没有呢?
其实是因为工程实现上,模型通常只输出 logits,不主动做 ,这样训练和推理阶段都能各自选择最合适的处理方式。
训练阶段通常使用 nn.CrossEntropyLoss 作为损失函数,其内部等价于 log_softmax 后再计算负对数似然,因此模型可以直接输出 logits。
推理阶段则可以根据 next_token 的选择策略灵活决定何时、对哪些部分做 。比如:
- 只选概率最大的 token 时可以直接用
argmax; - 要做带 temperature 的采样时,可以先对 logits 除以 再做 ;
- 要做 top-k 或 top-p 采样时,可以先选出候选集,再在候选集上做 ;
- 或者要做 beam search,每一步也只需要 logits 的相对大小来选 top-k 候选。
这样设计的好处是,模型不必在输出时立即对整个 logits 做 ,把这一步留给真正需要它的地方。
结语
本文以 Attention Is All You Need 这篇文章作为核心,讨论了 Transformer 中各个位置的计算细节, 尽量用准确的数学语言描述了模型的算法,并给出了相应的代码实现。
此外,本文还在文中提到了如 Dense FFN 和 MoE 等概念,这些内容我会在后续的文章中进一步展开。
希望本文对你理解 Transformer 有所帮助。