
前言
上一篇把 NVIDIA 的产品线捋了一遍。面对一张卡的规格表,真正要回答的其实只有两个问题:能不能跑,和跑多快。
能不能跑大体由显存容量说了算;跑多快则要分场景。对 LLM 来说,训练和 prefill 吃算力,逐 token decode 吃带宽,多卡场景还要再加一条互联。本文按这个顺序把规格表上的指标拆开讲,每个指标附上可以直接跑的实测代码。文章里的数字是公开 benchmark 和标称值,想验证自己手上的卡,代码拿去跑就是。
显存
容量
权重占用
显存的第一用途是装权重。估算很简单:
权重显存 ≈ 参数量 × 每参数字节数每参数字节数取决于量化精度:FP16/BF16 是 2 字节,FP8 是 1 字节,4-bit 量化约 0.5 字节,实际还要加 scale 等元数据,通常按 0.6–0.7 字节估。由此得到一张常用门槛表:
| 模型 | FP16 | FP8 | 4-bit |
|---|---|---|---|
| 7B | 14 GB | 7 GB | ~5 GB |
| 14B | 28 GB | 14 GB | ~9 GB |
| 32B | 64 GB | 32 GB | ~20 GB |
| 70B | 140 GB | 70 GB | ~42 GB |
这张表直接划出了消费卡的边界:24G 卡能装 4-bit 的 32B,5090 的 32G 离 4-bit 70B 还差一截,得降到 Q3 档才勉强塞下;4-bit 70B 需要 48G 以上的卡。
把模型权重的体积画成竖线、各卡显存画成横条,「哪张卡过哪条线」就一目了然:
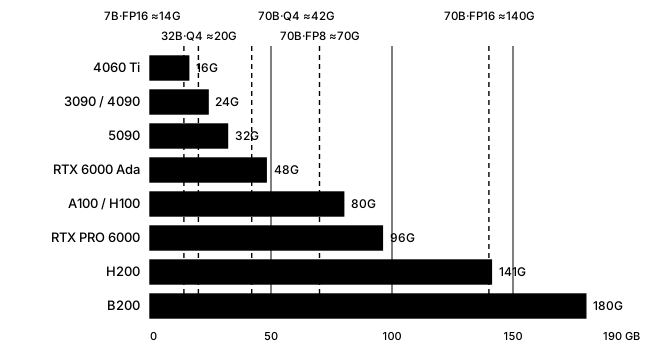
注意竖线只是权重体积。实际部署还要叠加下面说的 KV cache 和框架开销,所以「刚好压线」的卡实际上跑不了,得留出一截余量。
不过这条边界不是铁律,它假设的是权重常驻显存。另一条路是把不热的部分留在内存里随取随用:MoE 架构天然适合这套打法,每 token 只激活一小部分专家,热数据远小于总参数量,offload 之后仍能有可用的速度。开源社区已经有把这条路做到产品化的项目,比如 Strata 用 12 GB 显卡跑 125B 的 MoE 模型。代价也清楚:被 offload 的那部分读取带宽从显存的 TB/s 掉到内存的量级,所以 dense 模型这么玩基本不可行,MoE 是目前唯一划算的例外。本文后面的指标讨论仍以”权重常驻显存”这条主线为准。
权重之外的占用
权重之外还有三笔账:
- KV cache:推理时每个 token 的注意力历史都要存下来,大小正比于
层数 × KV 头数 × 头维 × 上下文长度 × batch。以 Llama-3.1-70B 这类 GQA 模型为例,每 token 约 0.3 MB,128k 上下文单请求就要吃掉 40 GB,长上下文场景里 KV cache 经常比权重更贵。 - 激活值:训练时反向传播要保留中间激活,随 batch 和序列长度线性增长,是训练显存的大头之一。
- 框架开销:CUDA context、cuDNN workspace、显存碎片,通常先按 1–2 GB 预留。
经验法则:估算需求时按 权重 + KV cache + 激活 算完,再留 20% 余量。
带宽
Decode 的带宽瓶颈
容量决定能不能跑,带宽决定跑多快。对 decode 阶段来说,带宽几乎是唯一决定因素。
原因在 decode 的访存模式:自回归生成每产出一个 token,都要把模型的全部权重从显存里读一遍,但每个权重只做一次乘加,算术强度极低。算力再强也得等数据喂到,所以单流 decode 的上限就是:
tokens/s ≤ 显存带宽 ÷ 每 token 读取的字节数每 token 读取的字节数约等于模型权重体积,再加上 KV cache 的读写。MoE 模型是个例外,只读激活专家:DeepSeek-V3 总参数 671B 但每 token 只激活 37B,所以它能用相对小的带宽跑出可观速度。实测效率一般是峰值的 60%–80%。
这个公式解释了很多现象:4-bit 量化能加速近 4 倍,因为读的字节少了四分之三;H100 推理比 4090 快得不成比例,因为 SXM 版带宽 3.35 TB/s 对 1.0 TB/s;带宽只有 273 GB/s 的 DGX Spark 跑 70B 就只能挤出个位数的 t/s。
代进具体数字,同一个 70B FP8 模型、每 token 读取约 70 GB,在各卡上的理论上限差距就是这么夸张:
单人要流畅交互大约需要 20 t/s 上下。这条虚线说明 70B 级别模型的「顺畅体验」基本是数据中心卡的专利;而 DGX Spark 虽然装得下,却只能以个位数速度吐字。反过来说,7B/14B 这种小模型因为每 token 读取量小一个数量级,消费卡的带宽就足够流畅,这就是为什么本地玩小模型的人不觉得卡慢。
GDDR 与 HBM
带宽 = 位宽 × 速率。消费卡用 GDDR6X/GDDR7,靠高频率补位宽:5090 是 512-bit × 28 Gbps ≈ 1792 GB/s。数据中心卡用 HBM,直接把位宽做到 4096–8192-bit,于是 H100 有 3.35 TB/s、B200 有约 8 TB/s。这不是工艺差距,是封装差距:HBM 是堆叠颗粒跟 GPU 封装在同一块基板上,消费卡的布线方式做不到这个位宽。所以带宽是消费卡和数据中心卡之间最难跨越的硬指标,靠堆料解决不了。
显存带宽测试
用设备到设备的拷贝测试显存带宽。拷贝既要读也要写,总流量是拷贝字节数的两倍,按 2 × nbytes 换算后可与规格表带宽比较。多卡机器上逐卡测试。
import timefrom pprint import pprint
import torch
def vram_bandwidth(device, nbytes=1 << 31, iters=50): """实测一张卡的显存带宽,返回 GB/s。""" src = torch.empty(nbytes, dtype=torch.uint8, device=device) dst = torch.empty_like(src) for _ in range(5): # warmup dst.copy_(src) torch.cuda.synchronize(device) t0 = time.perf_counter() for _ in range(iters): dst.copy_(src) torch.cuda.synchronize(device) return 2 * nbytes * iters / (time.perf_counter() - t0) / 1e9
pprint([{ "device": dev, "name": torch.cuda.get_device_name(dev), "bandwidth": f"{vram_bandwidth(dev):.0f} GB/s",} for dev in range(torch.cuda.device_count())], sort_dicts=False)Decode 速度估算
把前面的带宽瓶颈公式写成函数,代入显存带宽和模型大小即可估算:
def decode_tps(bandwidth_gbps, params_b, bytes_per_param, efficiency=0.7): """估算单流 decode 的 tokens/s 上限。""" return bandwidth_gbps * efficiency / (params_b * bytes_per_param)
# 几个例子:同一模型在不同卡上的差异,以及带宽更大的卡跑更大的模型print(decode_tps(1008, 32, 0.6)) # 4090 + 32B Q4 ≈ 37 t/sprint(decode_tps(1792, 32, 0.6)) # 5090 + 32B Q4 ≈ 65 t/sprint(decode_tps(3350, 70, 1)) # H100 + 70B FP8 ≈ 33 t/s这个估算只看权重读取,单流(batch=1)场景比较准;batch 开大之后权重被摊薄,瓶颈会逐渐转向算力和调度开销,那是生产部署的话题。
算力
CUDA 与 Tensor Core
规格表上”CUDA 核心”是传统意义上的通用执行单元,标量、访存、控制流都靠它;Tensor Core 是专门的矩阵乘单元,一次完成一小块矩阵的乘加,深度学习的绝大部分 FLOPs 都走这里。所以读算力只看 Tensor Core 那一栏,CUDA 核心数主要影响非矩阵部分和调度能力。
精度与算力口径
稀疏口径与 AI TOPS
Tensor Core 算力按精度分列:FP32/TF32、FP16/BF16、FP8、FP4,每降一档精度峰值大致翻倍。读这个数字时注意两个坑:
- dense vs sparse:NVIDIA 官方数字经常标稀疏值,那是 2:4 结构化剪枝下才兑现的口径,是稠密值的两倍。规格表脚注里的 “with sparsity” 就是这回事,对比时先统一口径。
- AI TOPS:消费卡宣传的 “AI TOPS” 通常是 INT4/FP4 稀疏口径的营销数字,和 FP16 稠密算力能差出一个数量级,不能直接拿来比。
峰值与实测差距
标称是峰值,实测永远打折:时钟会因功耗墙波动、kernel 利用率不可能 100%、大模型训练里 MFU(实际算力利用率)能做到 40%–55% 已是优秀水平。另外新精度有软件滞后期:FP8 在 H100 发布一年后才被主流框架用顺,FP4 现在仍在走这条路;买新卡冲新精度,要做好”头半年跑不出标称”的心理准备。
算力瓶颈与 Roofline
算力什么时候是瓶颈?看算术强度。prefill 和训练是 compute-bound:prompt 的几千个 token 可以并行算,权重被反复使用,算术强度远超带宽供给能力,这时峰值 FLOPS 直接兑现成吞吐。decode 反之是 bandwidth-bound,算力空转。
这个关系用 roofline 模型画出来最清楚:横轴是算术强度,即每读一字节能做多少运算;可达性能被「带宽斜线」和「算力天花板」夹在下方:
分水岭在拐点 AI* 处,也就是峰值算力除以带宽的位置。decode 的算术强度只有个位数,死死压在带宽斜线上,给它再强的 Tensor Core 也没用;而 prefill 和训练的几百 FLOP/B 早已越过拐点,此时唯一值钱的就是峰值算力。
一个实用推论:同一张卡,prefill 快不代表 decode 快。数据中心里 prefill 和 decode 甚至开始分开部署:算力强的卡做 prefill、带宽大的卡做 decode,这是后话。
矩阵算力测试
用矩阵乘法测试不同精度的算力:
import timefrom pprint import pprint
import torch
def matmul_tflops(device, dtype, n=8192, iters=20): """实测一张卡上 n×n matmul 的 TFLOPS。""" a = torch.randn(n, n, dtype=dtype, device=device) b = torch.randn(n, n, dtype=dtype, device=device) for _ in range(3): # warmup a @ b torch.cuda.synchronize(device) t0 = time.perf_counter() for _ in range(iters): a @ b torch.cuda.synchronize(device) dt = (time.perf_counter() - t0) / iters return 2 * n**3 / dt / 1e12
results = []for i in range(torch.cuda.device_count()): dev = f"cuda:{i}" fp16 = matmul_tflops(dev, torch.float16) bf16 = matmul_tflops(dev, torch.bfloat16) torch.set_float32_matmul_precision("highest") # 真 FP32 fp32 = matmul_tflops(dev, torch.float32) torch.set_float32_matmul_precision("high") # TF32 tf32 = matmul_tflops(dev, torch.float32) results.append({ "device": dev, "name": torch.cuda.get_device_name(i), "FP16": f"{fp16:.0f} TFLOPS", "BF16": f"{bf16:.0f} TFLOPS", "FP32": f"{fp32:.0f} TFLOPS", "TF32": f"{tf32:.0f} TFLOPS", })
pprint(results, sort_dicts=False)在大多数卡上会看到 FP16 ≈ BF16 ≫ TF32 > FP32 的阶梯,阶梯高度就是各档 Tensor Core 算力的差距。FP8 从 Ada(RTX 40 系)起就有硬件支持,可以通过 torch._scaled_mm 测;FP4 则是 Blackwell 独占。
互联
单卡之外,多卡场景下第三个维度是互联带宽。
PCIe
PCIe 是所有卡共用的基础互联:Gen4 x16 约 32 GB/s,Gen5 x16 约 64 GB/s,单向口径。多卡工作站常把 x16 拆成两个 x8,对 PCIe 来说 x8 Gen5 约等于 x16 Gen4,大多数量化推理感觉不到差别;但对数据搬运重的任务,通道数实打实减半。查拓扑用 nvidia-smi topo -m,它还会告诉你两张卡之间走不走 P2P。
NVLink
NVLink 是 GPU 间的专用直连总线,带宽远超 PCIe:
| 代际 | 代表卡 | 带宽(双向合计) |
|---|---|---|
| NVLink 3.0 | RTX 3090、A100 | 112.5 / 600 GB/s |
| NVLink 4.0 | H100/H200 | 900 GB/s |
| NVLink 5.0 | B200/GB200 | 1.8 TB/s |
读这张表有两个注意点。一是口径:NVLink 惯例按双向合计报,而上面 PCIe 的数字是单向,跨表对比时别忘了换算。二是范围:表里的带宽只在 NVLink 域内成立,域由 NVSwitch 或直连桥构成;出了域就是另一个世界:跨节点走 InfiniBand,NDR 400 Gb/s 大约 50 GB/s,比域内低一个数量级。这就是为什么 GPU 集群设计成”域内紧密、域间稀疏”的两级结构。
把这几档互联放在同一根对数轴上,「域内」和「域间」的落差一眼就能看出来:
对数轴上一个格就是十倍:PCIe 和 IB 挤在左侧几十 GB/s 的区间,而 NVLink 各代稳稳落在几百到上千 GB/s:「域内紧密、域间稀疏」不是比喻,是实打实的带宽断层。
P2P
P2P(peer-to-peer)指一张卡直接读写另一张卡的显存,不绕主存。数据中心卡上这是默认能力(GPUDirect P2P),延伸到网卡就是 GPUDirect RDMA:网卡直读显存,跨节点通信不过 CPU。消费卡在驱动层面禁用了它,后果是消费卡多卡通信只能走主存中转,带宽低一截。这正是上一篇说的”功能阉割”,也是下一篇偏方的突破口。
哪些并行方式吃互联:张量并行(TP)把单层切到多卡,每层都要 allreduce,对互联最敏感,基本绑定 NVLink 或至少 P2P;流水线并行(PP)只在 stage 边界传激活,PCIe 就够用;专家并行(EP)的 all-to-all 居中;数据并行(DP)每个 step 同步梯度,量大但频次低。选多卡方案时先想清楚用哪种并行,再决定互联预算。
其他指标
可靠性与虚拟化
ECC 显存是数据中心卡的标配,消费卡没有。单卡跑几小时感觉不到差别,千卡集群连跑几周就是硬需求。MIG 可以把一张 A100/H100 切成最多 7 个带隔离的实例,vGPU 支撑云厂商分时租赁,这两个都是数据中心卡独占。
功耗与散热
TDP 不只是电费问题:4 张 5090 就是 2.3 kW 的 GPU 功耗墙,家用插座和电源都是问题;散热形态决定能不能塞进多卡机箱:开放式风扇、涡轮、被动散热的处境完全不同;噪音决定这玩意能不能放客厅。这些指标在规格表上不占显眼位置,但每张卡都要落到真实的机箱里。
软件许可
GeForce 驱动的 EULA 限制数据中心部署,专业卡和数据卡没有这条。对个人玩票无影响,但对想拿消费卡建推理服务的人来说,这是采购合规层面真实存在的一条线,现实中的执行尺度是另一回事,下一篇偏方篇会再提。
结语
读 GPU 规格表的顺序可以浓缩成一句话:显存先划能不能常驻的线,带宽决定 decode 体验,算力决定训练与 prefill,互联决定多卡上限,剩下的 ECC、形态、许可按场景兜底。
指标会读了,下一篇进入实战:按本地推理、微调训练、生产部署三类场景,把谱系和指标合成选型决策。