
前言
第一篇里,我们用少数方向表示数据,提出了如何在压缩之后尽量保留原信息的问题。上一篇则发现,即使矩阵不是方阵, 和 也能帮我们寻找输入和输出两侧的方向。现在把这些方向接起来,就能看懂奇异值分解,即 Singular Value Decomposition,简称 SVD。
一个好用的切入方式,是先别急着记公式,而是问:一个矩阵对空间做了什么?本文沿用漫士沉思录《无痛线代》的 SVD 视频从三个连续动作观察变换的思路,用我们自己的图形来说明,再用本站吉祥物的真实图像重建看奇异值的作用。
矩阵的三个动作
先考虑二维空间中的一个矩阵 。我们画一枚带有方向标记的圆环:圆的轮廓帮助观察是否被拉伸,标记则让纯粹的旋转也看得出来。同一个图形依次经过三个动作:
换到输入方向
第一步是 。 的列是一组相互正交的单位方向, 将原来的坐标换成沿这些方向的坐标。它不会改变圆环的大小和形状,只会改变图形相对坐标轴的朝向;如果方向的选择还包含镜像,图形也可能被翻转。
这里的“换坐标”不等于丢弃坐标。 是完整的正交矩阵,,所以从新坐标乘回 就能精确还原输入。输入方向如何选,要等三个动作组合起来再看。
沿坐标轴缩放
第二步是 。它不混合不同方向,只沿坐标轴分别缩放。二维图里,圆环通常变成椭圆;某个方向的缩放量若是 ,整枚圆环就会被压成线段。 的对角线上这些非负的缩放量,便是矩阵的奇异值 ,约定按从大到小排列。
看图时容易把奇异值误读成“每个原始坐标轴的缩放量”。真正被单独缩放的是第一步换出的方向,未必与原始坐标轴重合。奇异值为 则表示对应的输入方向在输出里完全消失,这也解释了矩阵的秩为什么与非零奇异值的个数有关。
摆到输出空间
第三步是 ,它把缩放后的图形摆到输出空间的方向上。和 一样, 是正交矩阵,这一步改变的是方向,不改变刚刚得到的长度。于是对二维方阵,我们能按从右到左的顺序读出
图只是二维直觉。对任意实矩阵 ,SVD 都能写成
其中 、、。输入和输出甚至不必同维。此时 在 维输入空间换坐标,矩形的 除了缩放,还把坐标送到 维空间;最后 在输出空间确定朝向。、 均满足“转置乘自身等于单位矩阵”,而 只有主对角线可能非零。读公式时先检查这三个矩阵的形状,就不会把两侧的方向混为一谈。
奇异值与方向从哪里来
输入与输出的配对
上一篇已经知道, 是实对称且半正定的,因此有一组正交的输入特征方向。取其中的单位向量 ,设其特征值为 :
为什么要开平方?由于 ,有 。所以 ,正是这个单位输入方向经过 后的长度。当 时,把输出单位方向定义为 ,立刻得到
这就是图中三个动作的核心:左侧的输入方向 经 作用,被拉伸 倍并落到右侧的输出方向 。 和 也分别称为右奇异向量与左奇异向量,这里的左右说的是它们在 中的位置,与图中画的方向无关。对非零奇异值, 也是 的特征向量,因为 。两个方向必须这样配对,不能分别找出特征向量后不管顺序和正负号就拼在一起。
如果 ,则 ,无法除以 求 。完整分解中仍可用其他正交方向补齐 ,但这部分乘上零之后不会改变 。
接着算一个矩形矩阵
回到上一篇用过的 矩阵
上一篇已经验证,后一个矩阵沿 和 的特征值分别为 、。现在只需开平方:、。沿对应方向输出,得到
两个 既是单位向量,也彼此正交。把它们、奇异值和输入方向按对应顺序排好,便得到只保留非零部分的表示:
这里 ,,。两项已足以精确还原 。一般矩阵也可以只保留所有非零奇异值对应的列,叫作紧凑 SVD;它不丢信息,只是省掉乘出来全为零的部分。若为了压缩只留更少的项,等号才会变为近似。
把矩阵一层层拆开
每层贡献什么
设 的秩为 ,也就是非零奇异值有 个。把矩阵乘法按列与行展开,SVD 可以改写成
是一列, 是一行;相乘得到 矩阵 ,称为外积。它的每一列都是 的倍数,因此只有一个独立的列方向,是一层秩一矩阵。整张矩阵可以看成这些秩一层按 加权后叠起来:
拿刚才的 举例,前两层的数值恰好是
把它们相加就得到 。两层不只是两个“差不多”的方向:第一层负责两个输入坐标一起变化的部分,第二层补上它们的差异。只留下第一层时,矩阵秩从 降到 ,但第二层的变化也一并丢掉了。
截断与误差
若只保留最大的前 个奇异值,得到秩不超过 的矩阵
从 EP.0 我们已知道, 是所有矩阵元素误差的平方和。由于不同的秩一层由互相正交的 、 构成,误差没有交叉项,可以像勾股定理那样相加:
更强的结论是:在所有秩不超过 的矩阵中, 是 Frobenius 误差最小的一个。这是 Eckart–Young–Mirsky 定理。上面的平方和直接算出了截断的损失;定理进一步保证,即使换一种秩 的表示,也不能得到更小的平方误差。大的奇异值优先保留,但“前几个就够好”要看它们在具体矩阵里是否真的占据主要份额。
用一张图像观察截断
从像素到矩阵
接下来启动爱鞠TV,先铺上白色背景,再转为 的灰度像素矩阵。每个像素是 到 之间的数;这里没有对图像做中心化,求分解的是像素矩阵本身。对它实际计算 SVD,然后分别保留前 、、 层,裁剪重建值到可显示范围。结果如下:
| 原始灰度图 | |
|---|---|
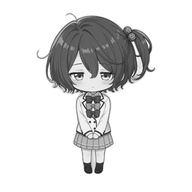 | 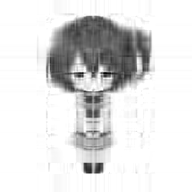 |
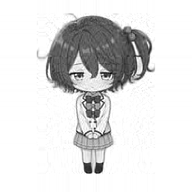 | 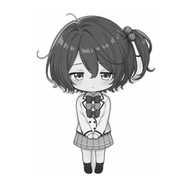 |
时仍能辨认轮廓,但线条和五官已模糊; 时主体逐渐清晰; 则更接近原图。这些是真实像素矩阵的截断重建,不是手动画的模糊效果,也不能据此推断任意图像都能用同样的 达到相同质量。
质量与存储
原始灰度矩阵有 个数。若把 的缩放量并入 ,只需存储两个因子,分别是 和 ,共 个数。不同 的数值数量和上述重建的像素均方根误差如下:
| 保留层数 | 因子中的数值数量 | 相对原矩阵 | 像素均方根误差 |
|---|---|---|---|
| 8 | 3,072 | 8.3% | 16.49 |
| 32 | 12,288 | 33.3% | 6.55 |
| 80 | 30,720 | 83.3% | 0.96 |
误差是在像素裁剪并四舍五入后,与原始灰度图逐像素比较所得。表里的百分比不是 PNG 文件大小的比例:原始像素是整数,分解后的因子通常要用浮点数保存,文件格式本身也会另外压缩。尤其当 较大时,因子未必比原始图片占更少字节。这个实验真正展示的是奇异值如何排列“保留哪些变化最划算”的次序,而不是提出比图片编码格式更好的压缩工具。
结语
SVD 把矩阵变换拆成换坐标、逐方向伸缩与摆放输出三个动作。 告诉我们从哪个输入方向看, 表示该单位方向被拉伸多少, 指明它落到哪里。把这些成对的方向按秩一层展开,留下前 层,就得到 Frobenius 意义下误差最小的低秩近似。
图像实验也说明,奇异值的排序本身不保证前几层就足够,只有当后面的奇异值足够小时,才可能用更少的数值保留大部分可见结构。