
前言
特征多而冗余时,把输入压到少数几个方向能省存储和算力,也常常顺手削掉噪声;想知道高维样本长什么样,压到两维、三维就能直接画出来观察类别结构。降维在 AI 里几乎无处不在。
具体怎么做?EP.0把降维看成往少数方向投影,留下了”选哪些方向”的问题;上一篇的 SVD 给出了一半答案:任意矩阵沿正交方向的变化有大有小,留下前 个就是最优的秩 近似。但把它直接用到真实数据上,还差一步:我们投影所用的子空间必须经过原点,而数据团的中心通常不在那里。补上这一步,就是主成分分析,Principal Component Analysis,简称 PCA。
数据中心化
过原点的子空间
低秩近似把数据投影到 个正交方向 张成的子空间上。子空间是线性结构,必过原点。真实数据不满足这一点:MNIST 的像素值全部非负,整团数据悬在空间的角落,离原点很远。
这时若仍要求投影方向过原点,第一条方向几乎只能指向数据团的中心,它先花掉一个成分去回答”数据在哪里”,而不是”数据怎样变化”。虚线标出数据真正的延展方向,和被迫过原点的直线并不重合:
均值平移
解决方式也直接:先算经验均值
再把每个样本减去它,得到中心化的数据矩阵
数据中心被平移到原点,过原点的子空间就不再吃亏。先中心化、再做最优低秩近似,这一整套流程合起来就是 PCA。下文公式中的 默认指已中心化的 。
最优子空间
字典矩阵
固定 ,哪 个方向让重构误差最小?写成优化问题:
是到 列空间的正交投影。EP.2已经给了答案:设 ,取前 个左奇异向量组成 。把它代进投影重构验证一下: 恰好”取出” 的前 行,于是
这正是截断 SVD,也就是 Eckart–Young–Mirsky 定理保证的最优秩 近似。所以
字典矩阵的列,就是中心化数据矩阵的前 个左奇异向量。
编码与重构
对任意样本 ,PCA 的降维与还原写成两条公式:
是样本在 个主方向下的坐标。注意重构要把均值加回去: 落在过 的仿射子空间上,而不是过原点的线性子空间。
还有一个常用细节。构造 时经常额外乘一个 :它把所有奇异值同倍缩放,左奇异向量不变,因此不影响 。好处是让 恰好等于样本协方差矩阵:
是对称矩阵,满足 。它的对角元 是第 个特征的样本方差;非对角元 是第 与第 个特征的样本协方差,取正、取负、接近零分别对应两个特征正相关、负相关与近似不相关。EP.0所说的特征冗余,在这里表现为 的非对角元显著非零。下一节会看到,把数据投影到 的特征方向上,得到的新特征彼此不相关,其中方差最大的方向正是主成分方向。
最大方差
投影后的方差
大多数教材中,PCA 更常见的说法是找方差最大的方向,这实际上和前文按最小重构误差求出的 是一样的。
投影到一条直线之后,每个样本就只剩一个数 ,即它在这条直线上的位置。沿不同直线投影,这串数的散开程度完全不同:沿数据延展的方向,数字分布得散;换接近垂直的方向,数字几乎挤在同一点附近。散得越开,说明样本之间的差异在这个方向上被保留得越多。这个”散开程度”的正式名字就是方差。
样本方差就是把每个投影坐标平方、再取平均。先把求和号里的一项展开:投影坐标是一个数,它的平方等于自己乘上自己的转置,可以写成 ;常数 与求和号又可以整体收进括号中间:
最后一步正是样本协方差矩阵 的定义。也就是说,数据沿任意方向的方差都可以写成 ,方向之间的差别全部由 决定。
那么哪个 让方差最大?在 的约束下,写拉格朗日函数 ,对 求导并令其为零,得到 。也就是说,投影最散的方向必须是协方差矩阵的特征向量,此时方差正好是特征值 。 是实对称矩阵,EP.1保证它有一组完整的正交特征方向;按特征值从大到小排,就依次得到第一、第二、第 个主成分方向。又因为 ,这些方向正是 的左奇异向量,方差与奇异值满足 。
两种视角的等价
“方差最大”和”误差最小”是同一件事。原因还是勾股定理:投影与残差互相垂直,
左边是样本到数据中心的距离平方,全部样本加起来正比于总方差,与 无关;右边两项分别是”保留下来的方差”与”丢掉的误差”。换句话说,每个样本离中心的距离是固定的,落进子空间里的部分越多,留在外面当残差的部分就越少,所以最小化重构误差,当且仅当最大化投影方差。
这也给出选 的依据:前 个方向保留的方差份额是 。实验一节会把它画出来。
手写数字实验
对 MNIST 实际做一遍。训练集 张 灰度图,每张拉直成 维向量,中心化后对 做特征分解,就得到全部主成分方向。
特征数字
均值 是一张”平均数字”:轮廓模糊,像所有字体的叠影。 的列则被称为特征数字,英文 eigendigits:
| 均值 | 前 个主成分方向 |
|---|---|
 | 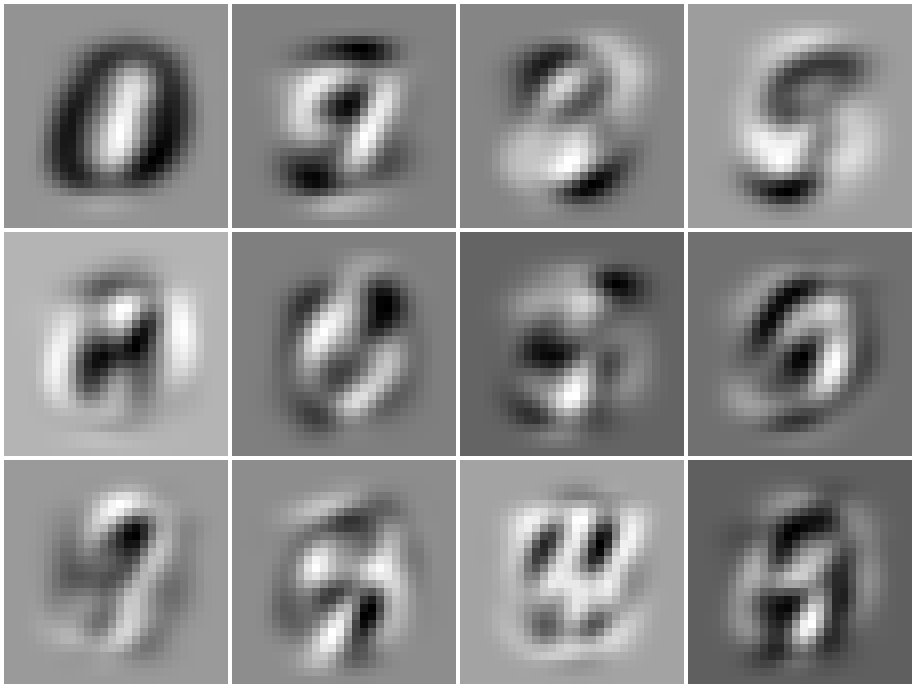 |
特征数字有正有负,本身不是数字,而是一块块”笔画修正模板”:靠前的调整整体轮廓的粗细与位置,靠后的越来越像局部的笔画碎片。每张图的近似就是
均值打底,各模板按系数 加减叠加。这组基是为手写数字量身定制的,所以几十块模板就能拼出大部分字形。
重建与残差
下图每行是一个测试样本,从左到右依次是原图与 的重构结果,全部是真实计算:
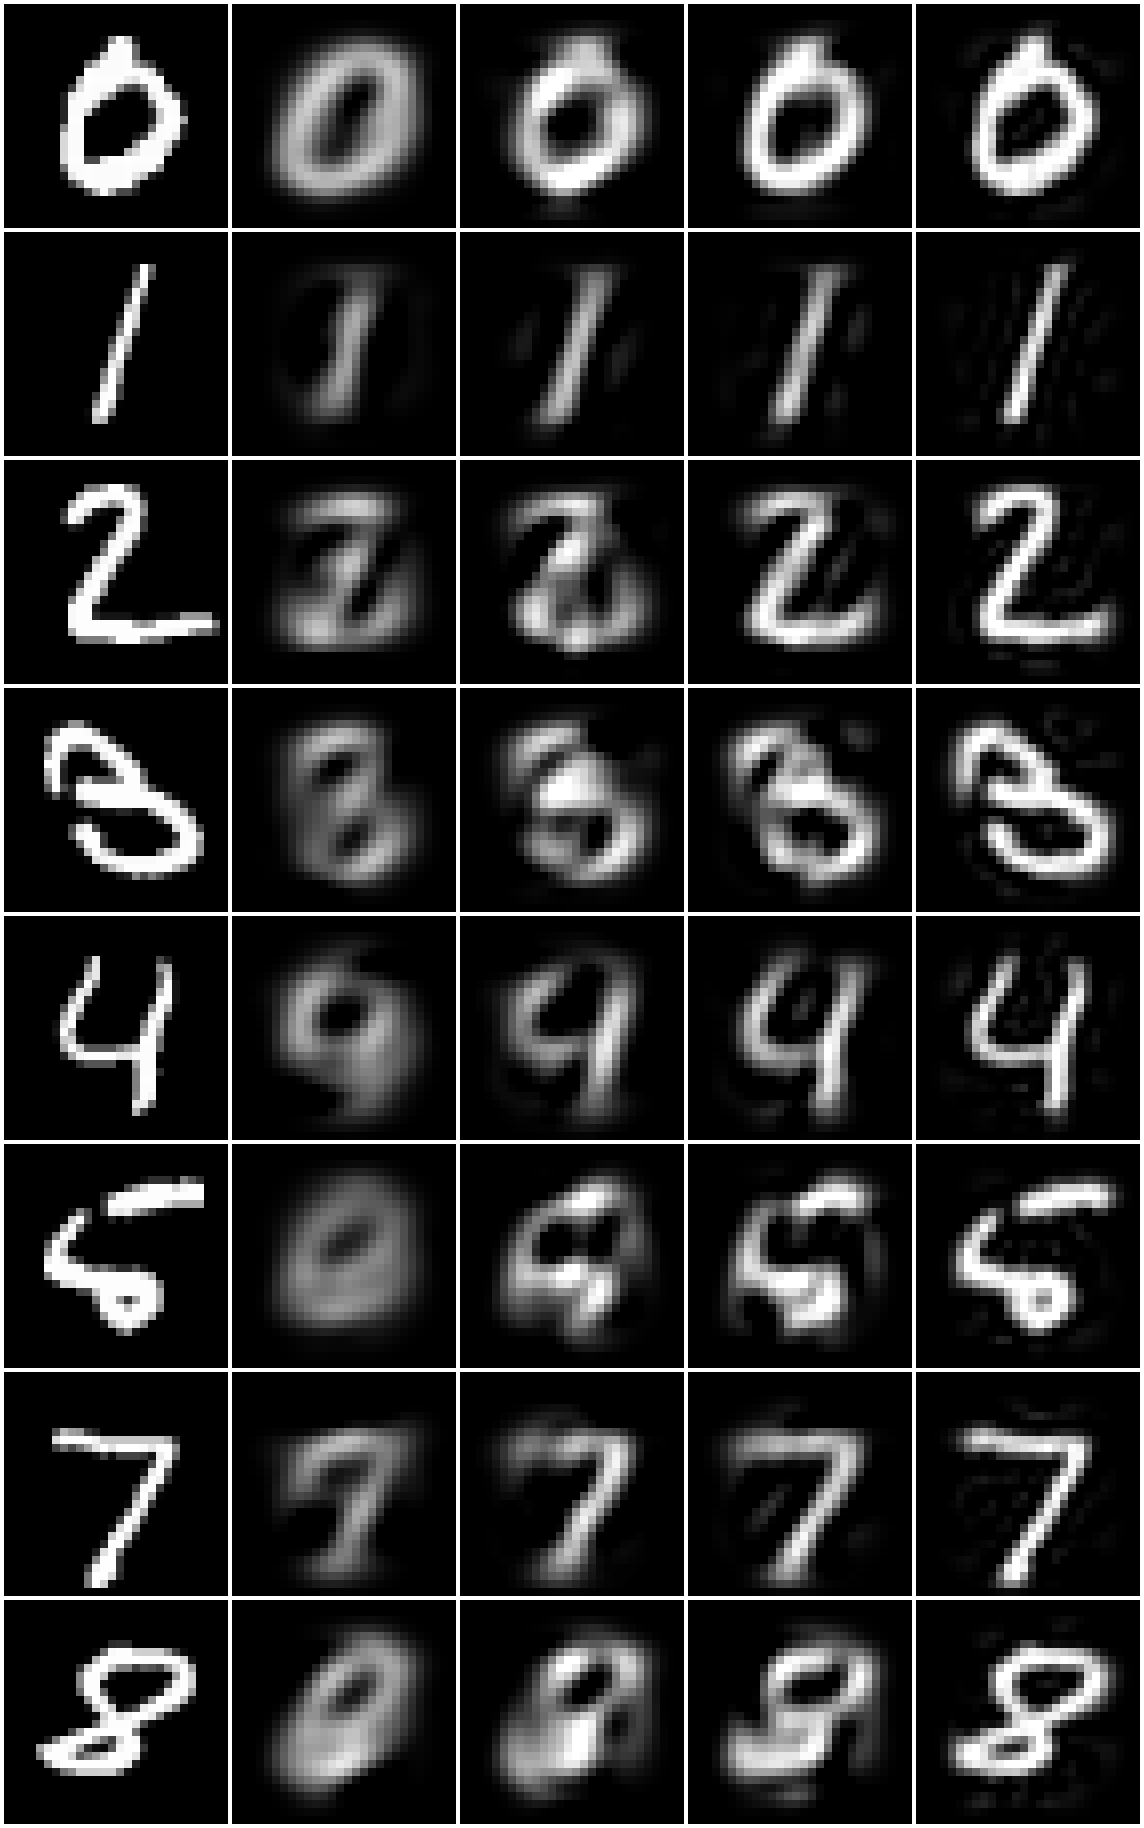
只剩大致轮廓; 时字形可辨,“1”这类结构简单的数字已经不错,“8”仍然模糊; 基本接近原图。被丢弃的尾项,对应的正是笔画细节与噪声。
方差曲线
各方向的方差 衰减得很快。左图是奇异值 ,右图是累计方差占比:
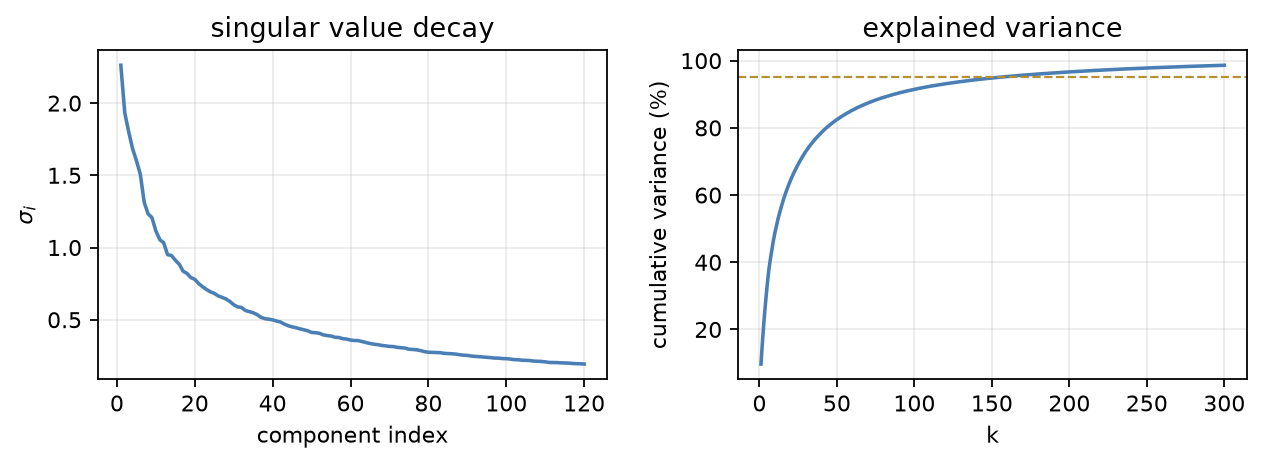
实际数字是: 保留约 的方差, 约 , 才到 。所以”留几个成分”没有普适答案,按目标份额选 ,再看一眼重建效果,比死记某个数字可靠。
线性的边界
编解码的耦合
回头看 PCA 的编码与重构: 与 都是线性映射,而且两个方向被同一个 的转置绑死。数据若躺在弯曲的非线性结构上,任何线性子空间都只能得到一个”拍扁”的近似:这不是 选多小的问题,而是方法本身的边界。
深度自编码器
放松约束的思路很自然:编码器、解码器分别用神经网络去学,目标不变,仍是最小重构误差
但不再要求线性,也不要求互为转置。这就是深度自编码器,auto-encoder: 把输入逐层压缩到一个低维”瓶颈”, 再逐层展开重建,整体呈漏斗形:
从这个角度看,PCA 是它的退化版本:编码和解码都只有一层线性变换,且权重恰好互为转置。
嵌入对比
同样压到 维,线性与非线性的差别可以直接看出来。我们在训练集上训练了一个小型自编码器 ,瓶颈就是二维编码 ;另一边取 PCA 的前两个主成分。把测试集的一万张图按真实类别着色:
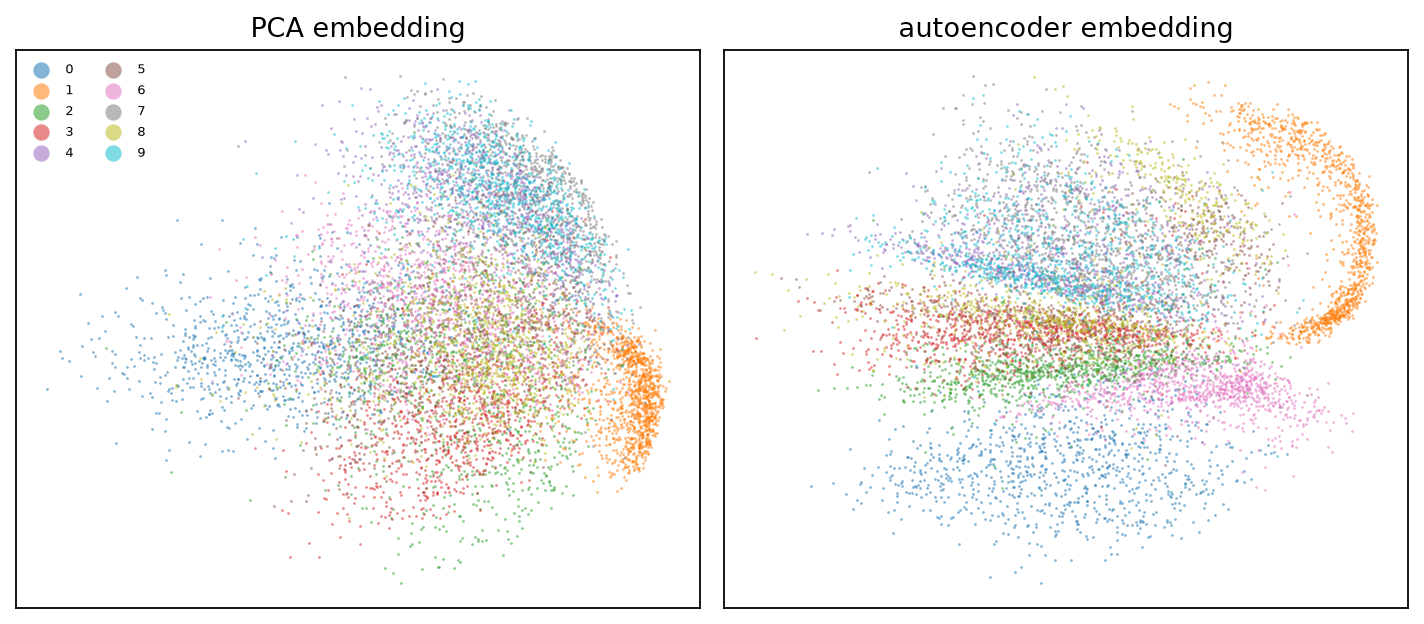
两张散点的坐标系不同,各自是两种方法给出的二维编码,可比的不是点的位置,而是簇的聚散。PCA 的投影里各类挤成一团,只有”1”大致分离出去;自编码器的编码则把若干类别扯成了相对分开的条带,“1”更是完全脱离主体。
代价同样真实:下面每行是一个测试样本的原图与这个小网络的重建,二维瓶颈太极端,输出比 PCA 保留几十个成分时模糊得多。
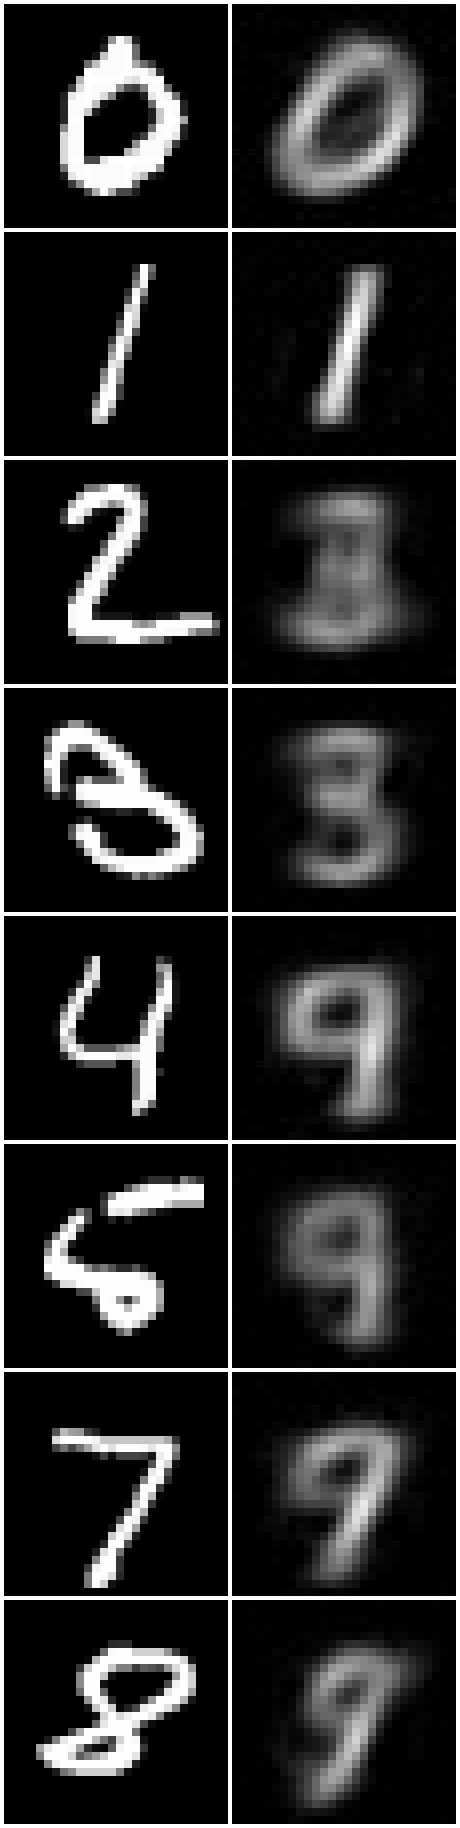
它优先保住的是结构的可分性,而不是还原细节。非线性方法能挖到线性方法漏掉的结构,这正是这条线索通向深度学习的入口。
结语
PCA 就三件事:先把数据中心化,让过原点的子空间不吃亏;再取中心化数据矩阵的前 个左奇异向量作字典,即 ;编码是 ,重构是 。它与”最大投影方差”是同一个最优解,选 时看保留的方差份额。而它的线性本质,正是自编码器要放松的约束。