本文是本站【深度学习】系列的第一篇文章,我们将直接从 Transformer 开始介绍,带你快速了解目前几乎所有大模型、智能体的底层核心模型是如何实现的。
Transformer 最初由 Google Brain 与 Google Research 团队在论文 Attention Is All You Need 提出,起初用于解决翻译问题。
Transformer 以更低的训练成本和更高的性能在当时成为了翻译领域的 SOTA,随后又被用于解决 NLP 领域的各种问题,且都具有极佳的表现。
本文将主要以这篇论文的 Transformer 进行介绍,后面都以“原始论文”代指。
本文假设读者已经有一定基础,如果你是纯小白,阅读本文可能会比较困难。不过我并不建议花费大量时间去补充基础,因为如果遇到不懂的概念,你随时可以请教AI,这将会为你节省很多时间。
本文主要聚焦 Transformer 模型的数学表示以及其代码实现,也就是说,我们会通过数学公式来表示 Transformer 各个模块的计算细节,并通过代码对其进行实现。
接下来,让我们进入正文。
模型架构#
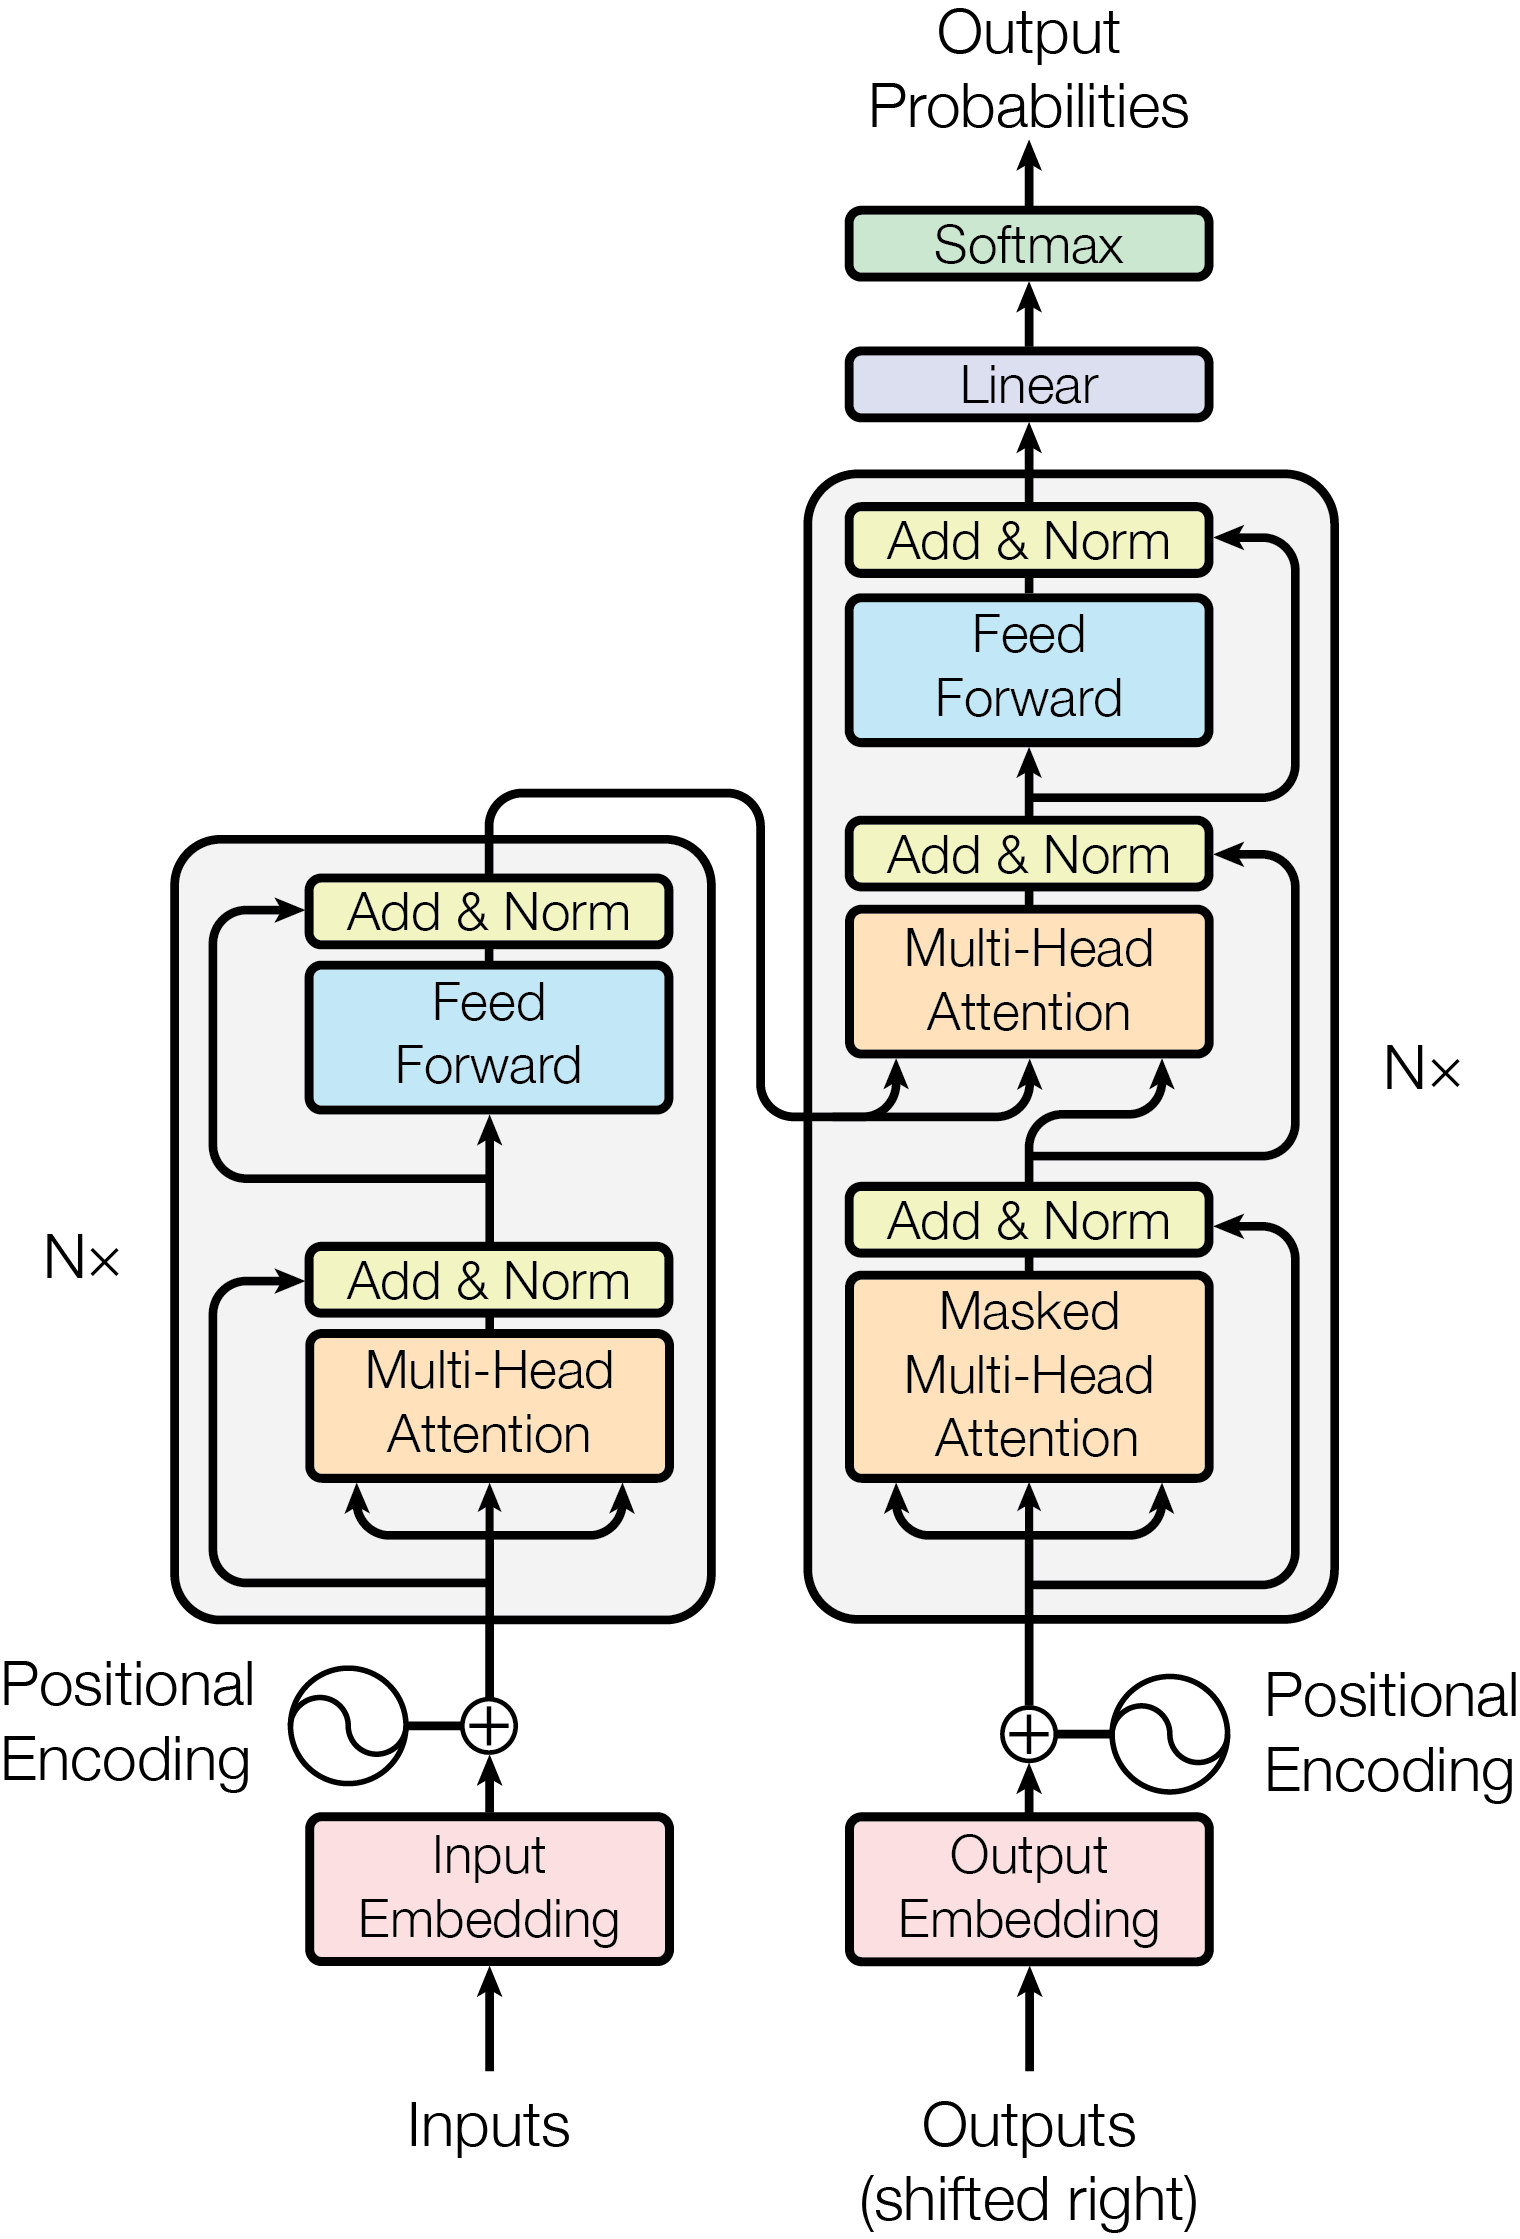
Transformer 使用了 Encoder-Decoder
接下来我们将分为 Encoder 和 Decoder 进行介绍。其中 Decoder 有许多基本计算模块和 Encoder 是相同的,因此不重复介绍相同的部分。
Encoder# 标准 Transformer 的 Encoder 由 6 个完全相同的 Encoder Block 堆叠而成,每一层的输入是上一层的输出。
每个 Block 包含两个 Sublayer:Multi-Head Attention (MHA) 和 Feed-Forward Network (FFN)。
每个子层都采用 Residual Connection,然后接 LayerNorm。
此外,在训练阶段,每个 Sublayer 的输出在进入残差连接之前会先经过 Dropout。
由于两个子层结构相同,都是“Dropout、残差、LayerNorm”的组合,只是内部函数 F F F
SubLayer F ( x ) = LN ( Dropout ( F ( x ) ) + x ) \text{SubLayer}_F(x) = \text{LN}(\text{Dropout}(F(x)) + x) SubLayer F ( x ) = LN ( Dropout ( F ( x )) + x ) 其中 F F F
EncoderBlock = SubLayer FFN ∘ SubLayer MHA \text{EncoderBlock} = \text{SubLayer}_{\text{FFN}} \circ \text{SubLayer}_{\text{MHA}} EncoderBlock = SubLayer FFN ∘ SubLayer MHA 接下来将展开讲解各个子层的计算细节。
MHA# MHA 可以说是整个 Transformer 的核心,其特点在 Self-Attention 和 Multi-Head 两部分。
Self-Attention# Self-Attention 指的是 Query、Key 和 Value 都通过同一个输入 x x x x x x W q W_q W q W k W_k W k W v W_v W v q q q k k k v v v
q = x W q , k = x W k , v = x W v q = x W_q, \quad k = x W_k, \quad v = x W_v q = x W q , k = x W k , v = x W v 由于序列中的每个 x x x X ∈ R n × d model X \in \mathbb{R}^{n \times d_{\text{model}}} X ∈ R n × d model n n n X X X
Q = X W q , K = X W k , V = X W v Q = X W_q, \quad K = X W_k, \quad V = X W_v Q = X W q , K = X W k , V = X W v 在上述矩阵运算中的权重矩阵 W q W_q W q W k W_k W k W v W_v W v x x x
得到 Query、Key、Value 后,我们就可以计算注意力分数和最终的注意力加权和了。
自注意力的意义在于捕捉序列内不同位置之间的依赖关系,因此我们跳过对单个输入的讨论,直接从矩阵形式开始说明 Transformer 如何使用点积计算注意力分数:
A ( Q , K ) = softmax ( Q K T d k ) A(Q, K) = \text{softmax}\left(\frac{Q K^T}{\sqrt{d_k}}\right) A ( Q , K ) = softmax ( d k Q K T ) 其中 d k d_k d k Q Q Q K K K
公式中还除以了 d k \sqrt{d_k} d k d k d_k d k d k \sqrt{d_k} d k
最外层使用 softmax \text{softmax} softmax
得到注意力分数后,就可以和 Value 矩阵 V V V
A t t e n t i o n ( Q , K , V ) = A ( Q , K ) V = softmax ( Q K T d k ) V Attention(Q, K, V) = A(Q, K)V = \text{softmax}\left(\frac{Q K^T}{\sqrt{d_k}}\right)V A tt e n t i o n ( Q , K , V ) = A ( Q , K ) V = softmax ( d k Q K T ) V 最终我们得到的就是经过注意力分数加权计算的注意力加权和。
Multi-Head# “多头”指的是在计算 Q Q Q K K K V V V W q W_q W q W k W_k W k W v W_v W v
Q i = X W q ( i ) , K i = X W k ( i ) , V i = X W v ( i ) Q_i = X W_q^{(i)}, \quad K_i = X W_k^{(i)}, \quad V_i = X W_v^{(i)} Q i = X W q ( i ) , K i = X W k ( i ) , V i = X W v ( i ) 其中 i i i X X X d model d_{\text{model}} d model h h h Q i Q_i Q i K i K_i K i d k d_k d k V i V_i V i d v d_v d v W q ( i ) ∈ R d model × d k W_q^{(i)} \in \mathbb{R}^{d_{\text{model}} \times d_k} W q ( i ) ∈ R d model × d k W k ( i ) ∈ R d model × d k W_k^{(i)} \in \mathbb{R}^{d_{\text{model}} \times d_k} W k ( i ) ∈ R d model × d k W v ( i ) ∈ R d model × d v W_v^{(i)} \in \mathbb{R}^{d_{\text{model}} \times d_v} W v ( i ) ∈ R d model × d v d k = d model / h d_k = d_{\text{model}} / h d k = d model / h h h h Q i Q_i Q i K i K_i K i d model d_{\text{model}} d model h h h h h h
每个头独立地做一次自注意力计算,得到各自的输出:
head i = softmax ( Q i K i T d k ) V i \text{head}_i = \text{softmax}\left(\frac{Q_i K_i^T}{\sqrt{d_k}}\right) V_i head i = softmax ( d k Q i K i T ) V i 然后将所有头的输出沿特征维度拼接,并通过线性层 W o W_o W o d model d_{\text{model}} d model
MHA ( X ) = Concat ( head 1 , … , head h ) W o \text{MHA}(X) = \text{Concat}(\text{head}_1, \dots, \text{head}_h) W_o MHA ( X ) = Concat ( head 1 , … , head h ) W o 其中每个 head i \text{head}_i head i d v d_v d v h ⋅ d v h \cdot d_v h ⋅ d v W o ∈ R ( h ⋅ d v ) × d model W_o \in \mathbb{R}^{(h \cdot d_v) \times d_{\text{model}}} W o ∈ R ( h ⋅ d v ) × d model W o W_o W o
原始论文设 d v = d model / h = d k d_v = d_{\text{model}} / h = d_k d v = d model / h = d k d k d_k d k d model d_{\text{model}} d model
FFN#
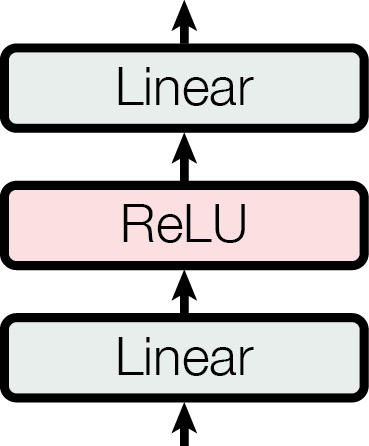
FFN 本质上是一个逐位置的 MLP,它对序列中每个位置独立地应用同一个两层全连接网络,因此不进行跨位置的信息混合。
由于这种 FFN 在每次前向传播中会激活全部参数,因此后来也被称为 Dense FFN,与之相对的是后来提出的 MoE 架构。
关于 MoE 我会在以后的文章讨论,这里就不展开了。
此处直接给出 FFN 层的计算公式:
FFN ( x ) = ReLU ( x W 1 + b 1 ) W 2 + b 2 \text{FFN}(x) = \text{ReLU}(x W_{1} + b_1) W_{2} + b_2 FFN ( x ) = ReLU ( x W 1 + b 1 ) W 2 + b 2 其中 W 1 ∈ R d model × d f f W_1 \in \mathbb{R}^{d_{\text{model}} \times d_{ff}} W 1 ∈ R d model × d f f W 2 ∈ R d f f × d model W_2 \in \mathbb{R}^{d_{ff} \times d_{\text{model}}} W 2 ∈ R d f f × d model d f f = 4 d model d_{ff} = 4 d_{\text{model}} d f f = 4 d model
Decoder# Decoder 和 Encoder 类似,也是由多个 Block 堆叠组成。一个 DecoderBlock 含有三个子层:Masked Multi-Head Attention、Cross Attention、FFN,每个子层同样采用残差连接、Dropout 和 LayerNorm。
DecoderBlock 本质上仍然是由 MHA 和 FFN 组成,其中 FFN 与 Encoder 完全一致。
沿用 Encoder 中的 SubLayer 抽象,DecoderBlock 可以表示为三个子层的复合:
DecoderBlock = SubLayer FFN ∘ SubLayer CrossAttention ∘ SubLayer MaskedAttention \text{DecoderBlock} = \text{SubLayer}_{\text{FFN}} \circ \text{SubLayer}_{\text{CrossAttention}} \circ \text{SubLayer}_{\text{MaskedAttention}} DecoderBlock = SubLayer FFN ∘ SubLayer CrossAttention ∘ SubLayer MaskedAttention Transformer 总共堆叠了 6 个 DecoderBlock。
关键区别在于 Decoder 的 MHA 具有两个特点:Masked Attention 和 Cross Attention。
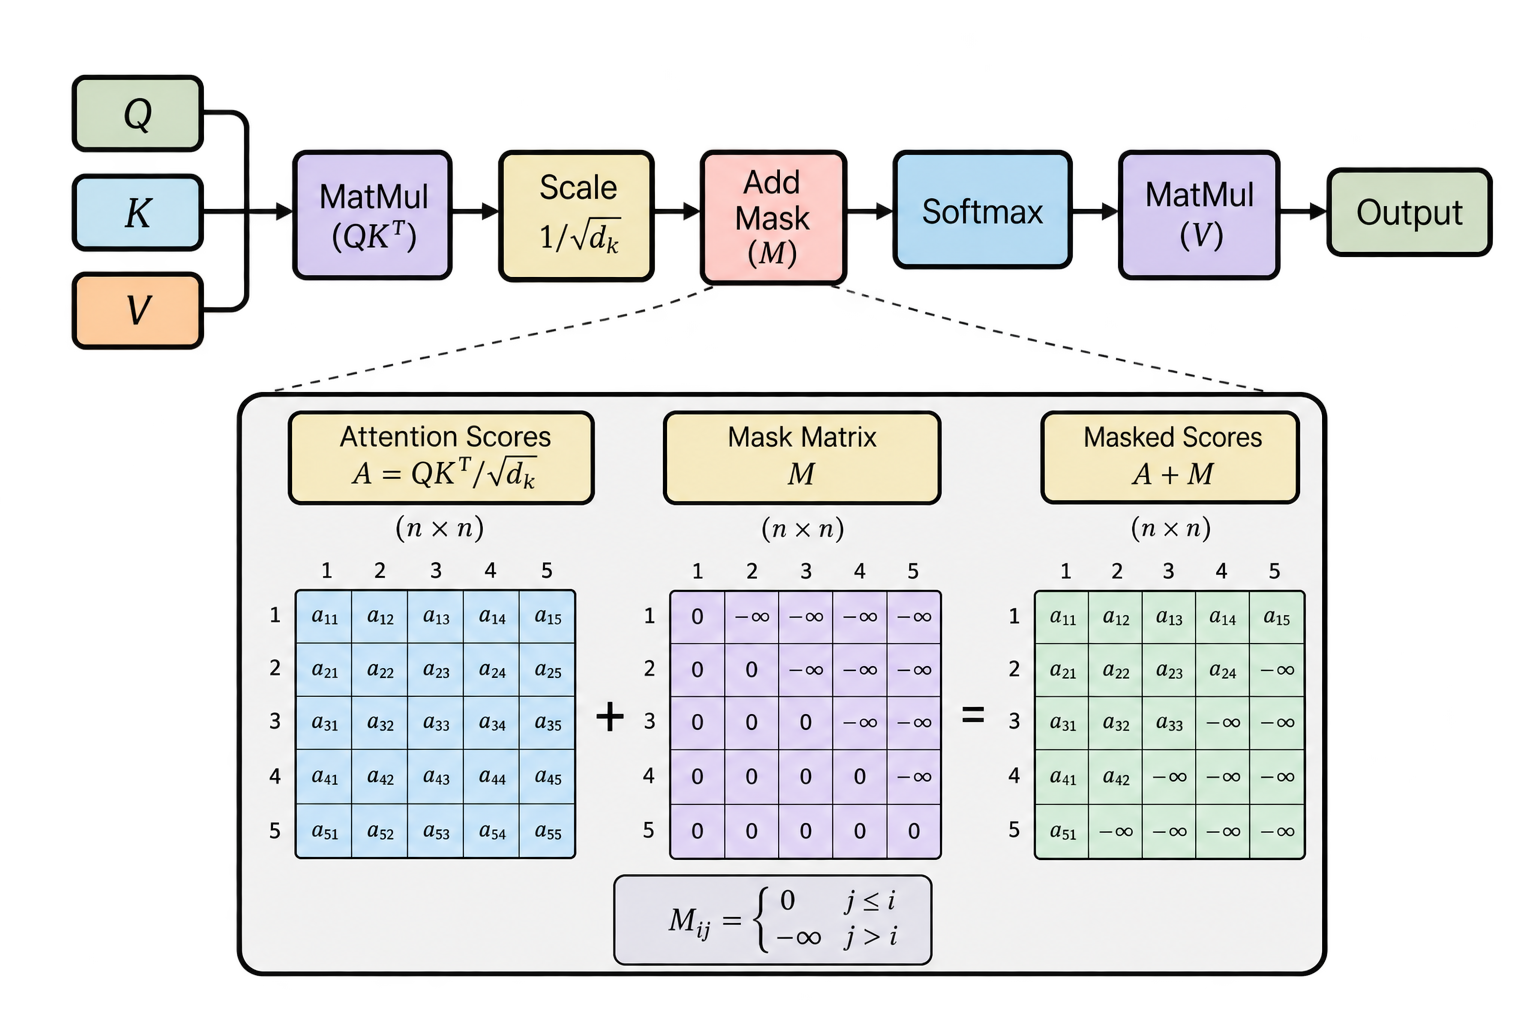
Masked Attention# 在训练阶段,我们通常采用 teacher forcing,也就是一次性把整个目标序列喂给 Decoder,让它预测每个位置的下一个 token。
此时位置 t t t t + 1 , t + 2 , … t+1, t+2, \dots t + 1 , t + 2 , …
为了避免这种情况,需要在计算注意力分数后,将未来位置的分数设为一个极大的负数,通常是 − ∞ -\infty − ∞
设注意力分数矩阵为 A = Q K T / d k ∈ R n × n A = Q K^T / \sqrt{d_k} \in \mathbb{R}^{n \times n} A = Q K T / d k ∈ R n × n M ∈ R n × n M \in \mathbb{R}^{n \times n} M ∈ R n × n
M i j = { 0 j ≤ i − ∞ j > i M_{ij} = \begin{cases} 0 & j \le i \\ -\infty & j > i \end{cases} M ij = { 0 − ∞ j ≤ i j > i 则 Masked Attention 可以表示为:
MaskedAttention ( Q , K , V ) = softmax ( A + M ) V \text{MaskedAttention}(Q, K, V) = \text{softmax}(A + M) V MaskedAttention ( Q , K , V ) = softmax ( A + M ) V Cross Attention# 前面我们在 Self-Attention 中默认 Q Q Q K K K V V V X X X Q Q Q K K K
head i = softmax ( Q i K i T d k ) V i \text{head}_i = \text{softmax}\left(\frac{Q_i K_i^T}{\sqrt{d_k}}\right) V_i head i = softmax ( d k Q i K i T ) V i 整体 MHA 表示为:
MHA ( Q , K , V ) = Concat ( head 1 , … , head h ) W o \text{MHA}(Q, K, V) = \text{Concat}(\text{head}_1, \dots, \text{head}_h) W_o MHA ( Q , K , V ) = Concat ( head 1 , … , head h ) W o 于是 Self-Attention 就是 MHA ( X , X , X ) \text{MHA}(X, X, X) MHA ( X , X , X )
Cross Attention 则把 Q Q Q K K K V V V Q Q Q Y Y Y K K K V V V H H H
CrossAttention ( Y , H ) = Concat ( head 1 , … , head h ) W o \text{CrossAttention}(Y, H) = \text{Concat}(\text{head}_1, \dots, \text{head}_h) W_o CrossAttention ( Y , H ) = Concat ( head 1 , … , head h ) W o 其中
head i = softmax ( ( Y W q ( i ) ) ( H W k ( i ) ) T d k ) ( H W v ( i ) ) \text{head}_i = \text{softmax}\left(\frac{(Y W_q^{(i)})(H W_k^{(i)})^T}{\sqrt{d_k}}\right) (H W_v^{(i)}) head i = softmax ( d k ( Y W q ( i ) ) ( H W k ( i ) ) T ) ( H W v ( i ) ) 其中 W q ( i ) ∈ R d model × d k W_q^{(i)} \in \mathbb{R}^{d_{\text{model}} \times d_k} W q ( i ) ∈ R d model × d k W k ( i ) ∈ R d model × d k W_k^{(i)} \in \mathbb{R}^{d_{\text{model}} \times d_k} W k ( i ) ∈ R d model × d k W v ( i ) ∈ R d model × d v W_v^{(i)} \in \mathbb{R}^{d_{\text{model}} \times d_v} W v ( i ) ∈ R d model × d v
这样设计的原因是:Decoder 在生成每个 token 时,需要参考完整的输入序列。
Query 来自 Decoder,表示“当前要生成什么”;Key 和 Value 来自 Encoder,表示“输入提供了哪些信息”。
计算上,Cross Attention 与普通 MHA 完全一致,唯一的区别就是 Q Q Q K K K V V V
线性分类头# Decoder 最后一层的输出经过一个线性层和 softmax,就得到了下一个 token 的概率分布:
p = softmax ( Z W out ) p = \text{softmax}(Z W_{\text{out}}) p = softmax ( Z W out ) 其中 Z ∈ R n × d model Z \in \mathbb{R}^{n \times d_{\text{model}}} Z ∈ R n × d model W out ∈ R d model × V W_{\text{out}} \in \mathbb{R}^{d_{\text{model}} \times V} W out ∈ R d model × V V V V p ∈ R n × V p \in \mathbb{R}^{n \times V} p ∈ R n × V
训练时,取 p p p
位置编码# 最后我们讲一下位置编码。
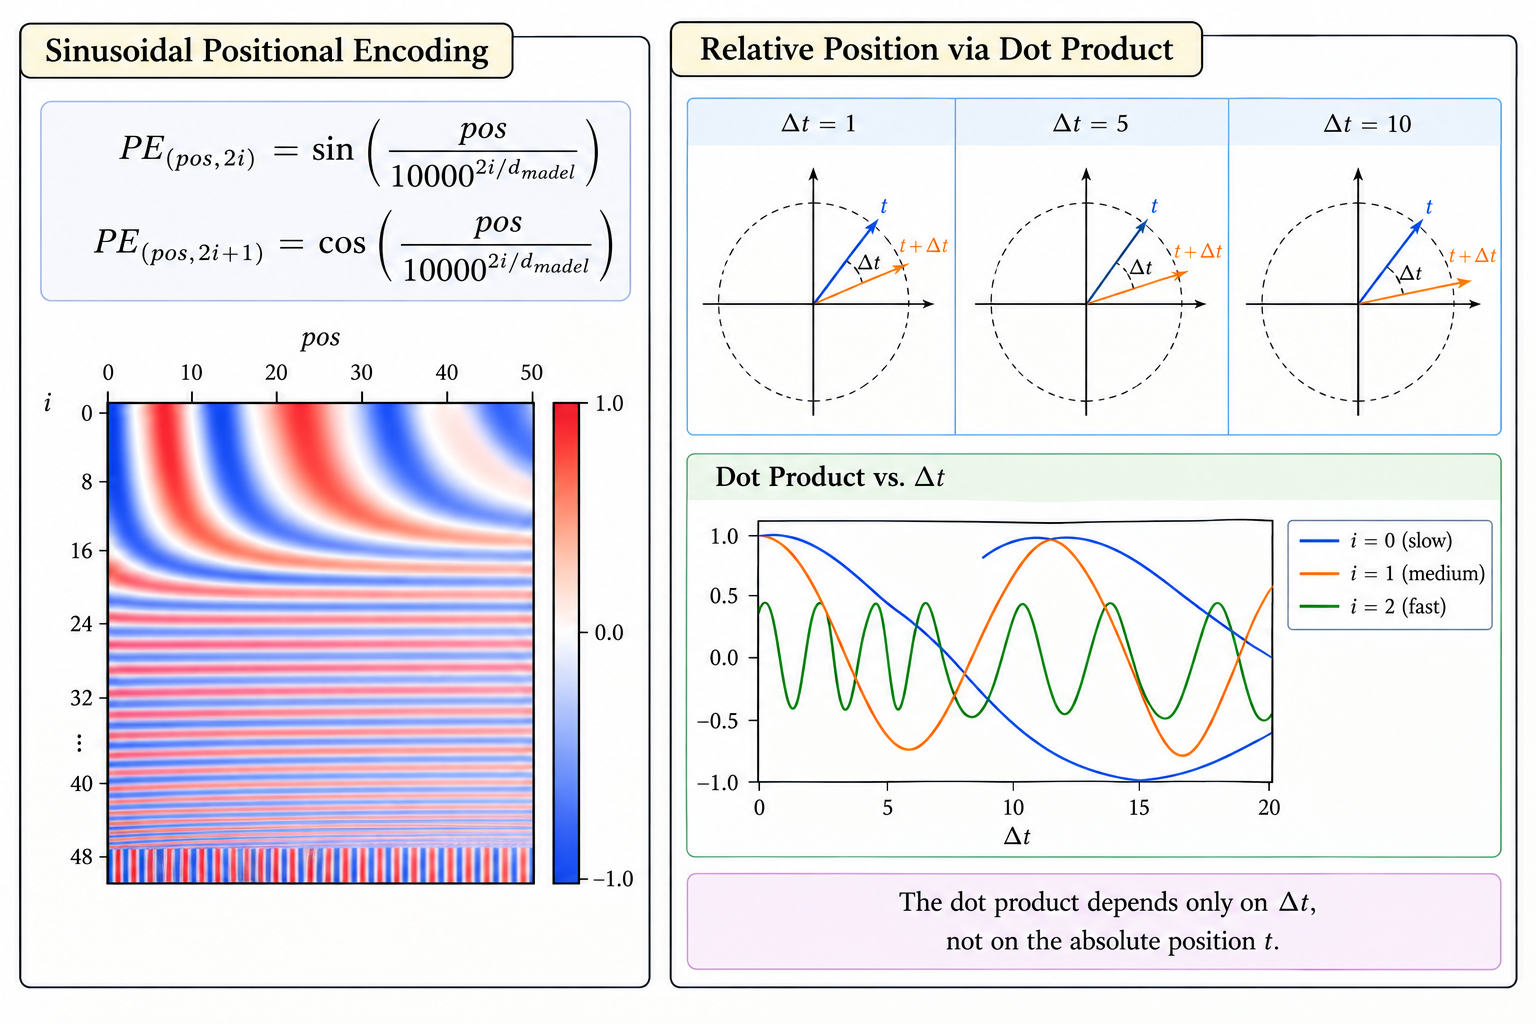
由于 Transformer 的自注意力机制本身对序列中 token 的顺序是不敏感的,即打乱输入序列的顺序,计算结果也不会改变。因此,我们需要额外为每个 token 注入位置信息。原始论文采用了一种基于正弦和余弦函数的固定位置编码:
P E ( p o s , 2 i ) = sin ( p o s 10000 2 i / d model ) PE_{(pos, 2i)} = \sin\left(\frac{pos}{10000^{2i / d_{\text{model}}}}\right) P E ( p os , 2 i ) = sin ( 1000 0 2 i / d model p os ) P E ( p o s , 2 i + 1 ) = cos ( p o s 10000 2 i / d model ) PE_{(pos, 2i+1)} = \cos\left(\frac{pos}{10000^{2i / d_{\text{model}}}}\right) P E ( p os , 2 i + 1 ) = cos ( 1000 0 2 i / d model p os ) 其中 p o s pos p os i i i i ∈ { 0 , 1 , … , d model / 2 − 1 } i \in \{0, 1, \dots, d_{\text{model}}/2 - 1\} i ∈ { 0 , 1 , … , d model /2 − 1 } 2 i 2i 2 i 2 i + 1 2i+1 2 i + 1 d model d_{\text{model}} d model
这种编码方式的一个重要性质是:它使得模型能够更容易地捕捉相对位置信息。考虑两个位置 t t t t + Δ t t + \Delta t t + Δ t ( sin ( w i t ) , cos ( w i t ) ) (\sin(w_i t), \cos(w_i t)) ( sin ( w i t ) , cos ( w i t )) ( sin ( w i ( t + Δ t ) ) , cos ( w i ( t + Δ t ) ) ) (\sin(w_i (t + \Delta t)), \cos(w_i (t + \Delta t))) ( sin ( w i ( t + Δ t )) , cos ( w i ( t + Δ t ))) w i = 10000 − 2 i / d model w_i = 10000^{-2i / d_{\text{model}}} w i = 1000 0 − 2 i / d model
( sin ( w i t ) , cos ( w i t ) ) ⋅ ( sin ( w i ( t + Δ t ) ) , cos ( w i ( t + Δ t ) ) ) (\sin(w_i t), \cos(w_i t)) \cdot (\sin(w_i (t + \Delta t)), \cos(w_i (t + \Delta t))) ( sin ( w i t ) , cos ( w i t )) ⋅ ( sin ( w i ( t + Δ t )) , cos ( w i ( t + Δ t ))) = sin ( w i t ) sin ( w i ( t + Δ t ) ) + cos ( w i t ) cos ( w i ( t + Δ t ) ) = \sin(w_i t)\sin(w_i (t + \Delta t)) + \cos(w_i t)\cos(w_i (t + \Delta t)) = sin ( w i t ) sin ( w i ( t + Δ t )) + cos ( w i t ) cos ( w i ( t + Δ t )) = cos ( w i Δ t ) = \cos(w_i \Delta t) = cos ( w i Δ t ) 可以看到,点积的结果只与相对位置 Δ t \Delta t Δ t t t t
本文以 Attention Is All You Need 这篇文章作为核心,讨论了 Transformer 中各个位置的计算细节,尽量用准确的数学语言描述了模型的算法。
除了数学表示,本文还希望通过代码让读者对计算过程有更加直观的理解,这部分暂时还在写作当中,尽情期待。
此外,本文还在文中提到了如 Dense FFN 和 MoE 等概念,这些是我在后续的文章中希望进一步介绍的,希望本文对你理解 Transformer 有所帮助。